从零搭建本地知识库:LangChain+Ollama混合检索实战

AI Summary (BLUF)
本文手把手带你搭建一个本地个人知识库问答系统,基于LangChain和Ollama实现混合检索(BM25+向量检索+RRF融合),涵盖环境配置、代码拆解和原理讲解,让你深入理解RAG的完整工作流程。
核心洞察
这篇文章最有意思的点,是把 RAGRetrieval-Augmented Generation - an AI framework that combines information retrieval with language generation to produce more accurate and contextually relevant responses. 落到了本地。模型用 OllamaA tool for running and managing AI models locally, supporting DeepSeek and other models. 跑,代码也就三百行,数据全在自己手里,不用付 API 钱。混合检索结合语义嵌入、关键词搜索和图遍历等多种检索技术的综合查询方法,旨在提高检索精度和效率。的融合逻辑值得多看两眼,RRFReciprocal Rank Fusion,一种按排名位置融合多路检索结果的算法。 算法只有十来行,效果比单独调向量或 BM25一种基于概率信息检索理论的文本检索模型,通过词频和逆文档频率对文档进行排名,考虑词项的相关性和稀有性。 都稳。
读完后,你能理解 RAG 为什么存在,掌握它的完整工作流程,独立跑通一个本地知识库问答项目。混合检索(BM25 加向量检索加 RRF 融合)的实现原理和它到底值不值,看完心里也有数。仓库链接放在文末。
核心结论
本文实现了一套完全本地运行的 RAG 知识库问答系统,技术栈为 Ollama + DeepSeek-R1 1.5B + nomic-embed-text + BM25 + FAISSFacebook's open-source library for efficient similarity search and clustering of dense vectors. + RRF,核心代码约 300 行,无需支付 API 费用,数据完全掌握在自己手中。
混合检索比单一检索更稳:FAISS 负责语义相似度,BM25 负责关键词精确匹配,两路各取 Top-5 后用 RRF 算法融合排名;RRF 的分数公式为
score = 1 / (k + rank),其中k = 60,同一文档在多路结果中的分数会累加。RRF 融合的典型效果可量化验证:一个文档在 FAISS 排第 2、BM25 排第 1 时,综合分约为 0.0325;而另一个仅在 FAISS 排第 1 的文档综合分约为 0.0164。前者反超后者,说明融合排名比单一检索结果更可靠。
项目支持索引持久化:首次构建 FAISS 和 BM25 索引约需 10 到 30 秒,之后每次启动直接加载;知识库文本按
chunk_size=500、chunk_overlap=50切块,示例中加载了 8 个文档块。项目通过两个自定义适配类
OllamaEmbeddings和OllamaChat,将 LangChainA framework for developing applications powered by language models through composable components. 标准接口与 Ollama API 对接,从而让本地运行的 DeepSeek-R1 1.5B 和 nomic-embed-text 模型无缝接入 LangChain 的 RAG 流程。
一、RAG 到底解决了什么问题
大模型很聪明,但它有一个天然的缺陷:知识有截止日期,而且它不认识你的私人文档。
举个例子。你问 GPT「我这篇论文的核心结论是什么?」它会一脸茫然,因为它根本没读过你的论文。
RAG(检索增强生成)就是干这个的:
用户提问 ──→ 在你的文档中检索 ──→ 把相关片段发给 LLM ──→ 生成答案
说白了就三步:检索,拼上下文,让 LLM 回答。
这样做有三个直接好处:
- 回答基于真实文档,不容易胡说八道
- 能接入最新文档,不受模型训练数据限制
- 答案可溯源,你知道回答来自哪篇文档
想深入了解 RAG 来龙去脉的话,可以读这篇《2026 RAG 全景:从大模型基座到 Agent 记忆中枢》,万字长文把全栈落地讲得很细。
二、项目概览:我们要搭什么?
今天基于 langchain-rag-tutorial 这个项目,手把手搭一个本地个人知识库问答系统,同时实现混合检索。
技术选型全部免费,本地运行:
| 类别 | 作用 | 技术实现 |
|---|---|---|
| LLM | 生成答案 | Ollama + DeepSeek-R1 1.5B |
| Embedding | 把文字转成向量 | Ollama + nomic-embed-text |
| 稀疏检索 | 关键词精确匹配 | BM25(rank-bm25) |
| 稠密检索 | 语义相似度搜索 | FAISS |
| 融合算法 | 多路检索结果合并 | RRF(倒数排名融合) |
| 应用框架 | 串联整个流程 | LangChain |
为什么需要混合检索?
单一检索方式总有盲区。纯向量检索靠语义相似度,相关的内容能搜到,但专有名词和精确短语容易漏。比如搜「Python list comprehension」,语义上能碰到「列表推导式」,反过来就不一定。纯 BM25 做关键词精确匹配,效果好但不理解同义词。
混合检索让两路各发挥所长,再用 RRF 算法融合排名,精确和语义都顾得上。
项目结构:
langchain-rag-tutorial/
├── main.py                    # 核心代码(包含混合检索)
├── pyproject.toml             # 依赖配置
├── data/
│   └── knowledge_base.txt     # 知识库文件
├── faiss_index/               # 运行后自动生成
│   ├── index.faiss            # FAISS 向量索引
│   └── index.pkl              # FAISS 索引元数据(原写法遗漏)
├── bm25_index.pkl             # BM25 索引(持久化)
└── tests/
    └── test_main.py
三、环境准备
1. 安装 uv(Python 包管理工具)
# macOS
curl -LsSf https://astral.sh/uv/install.sh | sh

# Windows
powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex"
2. 安装 Ollama
去 ollama.com 下载安装,然后运行:
# 下载所需模型(ollama serve 会自动后台运行,无需手动执行)
ollama pull deepseek-r1:1.5b    # LLM 模型
ollama pull nomic-embed-text    # 向量嵌入模型
3. 克隆并安装项目依赖
git clone https://github.com/tangcheng/langchain-rag-tutorial.git
cd langchain-rag-tutorial
uv sync
四、核心代码逐行拆解
从 main.py 入手,把整个 RAG 流程拆开看。
4.1 两个自定义类:让 Ollama 对接 LangChain
LangChain 原生接口是按 OpenAI 那套设计的,要接 Ollama 就得写个适配层。两个类分别处理 Embedding 模型和 LLM。
Embedding 模型适配器:
from langchain_core.embeddings import Embeddings
from typing import List
import ollama

class OllamaEmbeddings(Embeddings):
    def __init__(self, model: str = "nomic-embed-text"):
        self.model_name = model

    def embed_documents(self, texts: List[str]) -> List[List[float]]:
        return [self.embed_query(text) for text in texts]

    def embed_query(self, text: str) -> List[float]:
        return ollama.embeddings(model=self.model_name, prompt=text)["embedding"]
LLM 模型适配器:
from langchain_core.messages import BaseMessage

class OllamaChat:
    def __init__(self, model: str = "deepseek-r1:1.5b"):
        self.model = model

    def invoke(self, messages: List[BaseMessage]) -> str:
        # 拼接多轮消息
        prompt = "\n".join([msg.content for msg in messages])
        response = ollama.chat(
            model=self.model,
            messages=[{"role": "user", "content": prompt}]
        )
        return response["message"]["content"]
这两个类的作用就是翻译器,一边是 LangChain 的标准接口,另一边是 Ollama 的 API。
4.2 文档加载:读入你的知识库
import os
from langchain_text_splitters import CharacterTextSplitter
from langchain_core.documents import Document as LCDocument

def load_documents():
    with open("./data/knowledge_base.txt", "r", encoding="utf-8") as f:
        content = f.read()

    text_splitter = CharacterTextSplitter(
        separator="\n\n",
        chunk_size=500,      # 每块最多 500 字符
        chunk_overlap=50,    # 块之间重叠 50 字符(防止割裂语义)
        length_function=len
    )
    chunks = text_splitter.split_text(content)

    documents = [
        LCDocument(page_content=chunk, metadata={"source": "knowledge_base.txt"})
        for chunk in chunks if chunk.strip()
    ]
    return documents
为什么切块?LLM 有上下文窗口限制,语义连贯的小块文本更容易被检索。块之间留重叠,是为了防止跨块的关键信息被切断。
4.3 两路索引:FAISS(稠密)+ BM25(稀疏)
这是项目里最关键的部分,同时维护两套索引。
FAISS 向量索引(稠密检索):
from langchain_community.vectorstores import FAISS

INDEX_DIR = "./faiss_index"
BM25_PKL = "./bm25_index.pkl"
RETRIEVE_K = 5
FUISON_K = 5
RRF_K = 60

def build_index(documents, embed_model):
    # 已有则直接加载
    if os.path.exists(INDEX_DIR):
        print("📦 检测到已有 FAISS 索引,加载中...")
        return FAISS.load_local(
            INDEX_DIR, embed_model,
            allow_dangerous_deserialization=True
        )

    print("🔍 构建 FAISS 向量索引...")
    vectorstore = FAISS.from_documents(
        documents=documents,
        embedding=embed_model   # OllamaEmbeddings 把文本转成向量
    )
    vectorstore.save_local(INDEX_DIR)
    return vectorstore
BM25 倒排索引(稀疏检索):
import pickle
from rank_bm25 import BM25Okapi

def build_bm25_index(documents: List[LCDocument]):
    """构建 BM25 倒排索引,支持持久化"""
    if os.path.exists(BM25_PKL):
        print("📦 检测到已有 BM25 索引,加载中...")
        with open(BM25_PKL, "rb") as f:
            return pickle.load(f)

    print("🔍 构建 BM25 索引...")
    doc_texts = [doc.page_content for doc in documents]
    # 简单分词:空格分割 + 小写化
    tokenized_corpus = [doc.lower().split() for doc in doc_texts]
    bm25 = BM25Okapi(tokenized_corpus)

    # 持久化到本地
    bm25_data = {"bm25": bm25, "doc_texts": doc_texts}
    with open(BM25_PKL, "wb") as f:
        pickle.dump(bm25_data, f)
    print("   BM25 索引创建完成!")
    return bm25_data
BM25 可以理解成 TF-IDF 的改良版。对每个查询词,TF 衡量它在文档里出现的频率,出现越多越相关,但超过一定限度会打折。IDF 衡量词的稀缺程度,越罕见的词区分度越高。公式里的饱和函数让词频增长有上限,避免简单词频统计带来的偏差。
4.4 RRF 融合算法:把两路结果合并排序
两路检索各说各话,怎么合并成一个统一排名?用 RRF(倒数排名融合):
def reciprocal_rank_fusion(results: List[List[dict]], k: int = 60) -> List[dict]:
    """
    RRF 算法核心思想:
    对每个检索器返回的结果,按排名分配分数:score = 1 / (k + rank)
    排名越靠前,分数贡献越大。不同检索器中同一文档的分数累加。
    """
    doc_scores = {}

    for retriever_results in results:
        for rank, item in enumerate(retriever_results, start=1):
            doc_key = item["doc"].page_content
            if doc_key not in doc_scores:
                doc_scores[doc_key] = {"doc": item["doc"], "rrf_score": 0.0}
            # 累加 RRF 分数(排名越靠前,贡献越大)
            doc_scores[doc_key]["rrf_score"] += 1.0 / (k + rank)

    # 按综合分数降序排列
    fused = sorted(doc_scores.values(),
                   key=lambda x: x["rrf_score"], reverse=True)
    return fused
RRF 为什么有效?
假设一个文档在 FAISS 排第 2,在 BM25 排第 1:
- FAISS 贡献:1 / (60 + 2) ≈ 0.0161
- BM25 贡献:1 / (60 + 1) ≈ 0.0164
- 综合分数:0.0325
另一个文档只在 FAISS 排第 1,综合分数只有 1/61 ≈ 0.0164,被前者反超。排名累加之后,综合结果比任何单一检索器都稳。
参数 k=60 是经验值,越大两路结果越均衡。
4.5 混合检索:把三件事串起来
def dense_search(vectorstore, query: str, k: int) -> List[dict]:
    docs = vectorstore.similarity_search(query, k=k)
    return [{"doc": doc, "score": 1.0} for doc in docs]

def hybrid_search(vectorstore, bm25_data, documents, query: str) -> List[LCDocument]:
    """
    混合检索完整流程:
    1. FAISS 向量检索 → Top-5
    2. BM25 稀疏检索 → Top-5
    3. RRF 融合 → 最终 Top-5 排名
    """
    bm25 = bm25_data["bm25"]
    doc_texts = bm25_data["doc_texts"]

    # 两路并行检索
    dense_results = dense_search(vectorstore, query, k=RETRIEVE_K)
    sparse_results = sparse_search(bm25, doc_texts, query, documents, k=RETRIEVE_K)

    print(f"   📊 FAISS 命中: {len(dense_results)} 条 | BM25 命中: {len(sparse_results)} 条")

    if not sparse_results:
        # 无 BM25 时,降级为纯向量检索
        return [item["doc"] for item in dense_results[:FUISON_K]]

    # RRF 融合
    fused = reciprocal_rank_fusion([dense_results, sparse_results], k=RRF_K)

    # 打印融合排名(方便调试理解)
    print("   🏆 RRF 融合排名(Top-5):")
    for i, item in enumerate(fused[:5], 1):
        preview = item["doc"].page_content[:40].replace("\n", " ")
        print(f"      [{i}] 分数={item['rrf_score']:.3f}  |  {preview}...")

    return [item["doc"] for item in fused[:FUISON_K]]
稀疏检索实现:
def sparse_search(bm25, doc_texts, query, documents, k):
    if bm25 is None:
        return []
    tokenized_query = query.lower().split()
    scores = bm25.get_scores(tokenized_query)
    top_indices = sorted(range(len(scores)),
                        key=lambda i: scores[i], reverse=True)[:k]
    return [
        {"doc": documents[idx], "score": float(scores[idx])}
        for idx in top_indices if scores[idx] > 0
    ]
4.6 问答:检索 + 生成
def answer_question(question, vectorstore, bm25_data, documents, llm):
    # 混合检索 Top-5
    docs = hybrid_search(vectorstore, bm25_data, documents, question)

    # 拼 Prompt,发给 LLM
    context = "\n\n".join([doc.page_content for doc in docs])
    prompt = f"""基于以下上下文回答问题。如果无法从上下文找到答案,请如实说明。

上下文:
{context}

问题: {question}

回答:"""

    print(f"\n❓ 问题: {question}")
    print(f"📖 参考 {len(docs)} 个文档片段:")
    for i, doc in enumerate(docs, 1):
        print(f"   [{i}] {doc.page_content[:60].replace(chr(10), ' ')}...")

    response = llm.invoke([prompt])
    print(f"\n✅ 答案:\n{response}")
五、跑起来
uv run python main.py
首次运行会同时构建 FAISS 索引和 BM25 索引,大约 10 到 30 秒。之后每次启动直接加载,不会重复构建。正常运行时的输出:
🔧 初始化 Ollama LLM...
🔧 初始化 Ollama Embedding...
📚 加载知识库文档...
   已加载 8 个文档块
📦 检测到已有 FAISS 索引,加载中...
📦 检测到已有 BM25 索引,加载中...

==================================================
💬 开始混合检索问答测试(FAISS + BM25 + RRF)
==================================================

❓ 问题: 什么是 LlamaIndex?
   🔎 混合检索: query =「什么是 LlamaIndex?」
   📊 FAISS 命中: 5 条 | BM25 命中: 5 条
   🏆 RRF 融合排名(Top-5):
      [1] 分数=0.0325  |  LlamaIndex(formerly GPT Index)是一...
      [2] 分数=0.0246  |  RAG(检索增强生成)是 LlamaIndex 的...
      [3] 分数=0.0245  |  核心概念包括文档加载器、索引、查询引...
      [4] 分数=0.0164  |  LlamaIndex 为构建 LLM 应用提供了...
      [5] 分数=0.0161  |  与 LangChain 的关系:两者可以结合使用
📖 参考 5 个文档片段:
   [1] LlamaIndex(formerly GPT Index)是一...
   ...

✅ 答案:
 LlamaIndex 是一个强大的数据框架...
看 RRF 排名那一列,能清楚看到两路检索各自的贡献。有些文档 FAISS 排第 1 但 BM25 没命中,有些反过来。融合后的 Top-1,就是综合最优解。
六、完整的混合检索流程图解
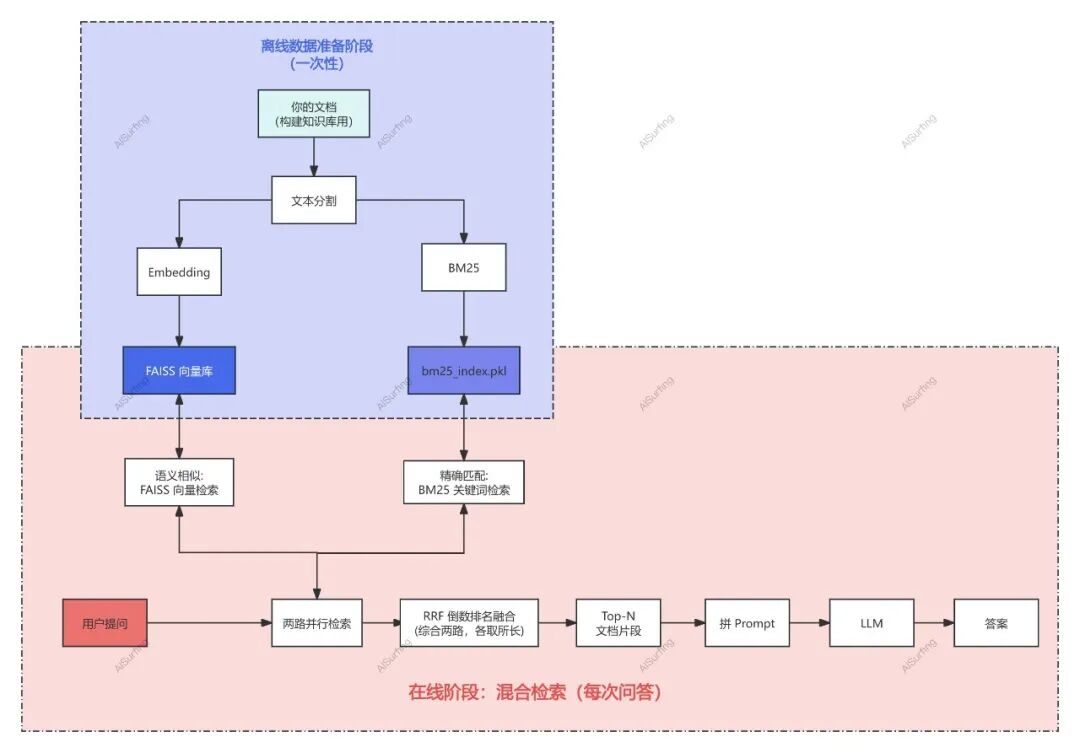
离线阶段构建文档向量库和 BM25 索引。在线问答时,语义检索和关键词检索并行执行,经过 RRF 融合后,取 Top-5 片段输入 LLM 生成答案。
七、核心概念回顾
| 概念 | 代码 | 说明 |
|---|---|---|
| Document | LCDocument(page_content=chunk) | 一个可检索的文本块 |
| Embeddings | OllamaEmbeddings | 把文本转成向量(稠密表示) |
| VectorStore | FAISS | 存向量 + 做相似度搜索 |
| BM25 | BM25Okapi | 倒排索引,基于词频稀疏检索 |
| RRF | reciprocal_rank_fusion() | 多路检索结果融合算法 |
| LLM | OllamaChat | 基于上下文生成答案 |
| Text Splitter | CharacterTextSplitter | 把大文档切成小块 |
| Retrieval | hybrid_search() | 混合检索获取相关片段 |
八、跑通之后,你可以做什么?
扩展 1:换成你自己的文档
把 data/knowledge_base.txt 换成你的内容就行。项目还支持接入 PDF、Word、网页、Notion、Slack、数据库等各类数据源。
扩展 2:加聊天历史(多轮对话)
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.runnables.history import RunnableWithMessageHistory

history = InMemoryChatMessageHistory()
chain_with_history = RunnableWithMessageHistory(
    rag_chain,
    history,
    input_messages_key="question",
    history_messages_key="chat_history"
)
扩展 3:做个 Web UI
用 Streamlit 几行代码就能跑出网页界面:
import streamlit as st

question = st.text_input("问一个问题:")
if question:
    docs = hybrid_search(vectorstore, bm25_data, documents, question)
    st.write(llm.invoke([build_prompt(docs, question)]))
扩展 4:部署成 API 服务
from fastapi import FastAPI
app = FastAPI()

@app.post("/ask")
def ask(question: str):
    docs = hybrid_search(vectorstore, bm25_data, documents, question)
    return {"answer": llm.invoke([build_prompt(docs, question)])}
扩展 5:调参优化
混合检索有几个关键参数可以调:
RETRIEVE_K:每路检索取多少条,越多混合越充分,噪音也跟着涨RRF_K:融合参数,越大两路结果越均衡,通常取 60 左右chunk_size:切片大小,太小语义容易碎,太大又混进噪音,500 是经验起点
九、总结
从零跑通一个完整的本地 RAG 系统,核心链路分三层。
索引层(一次性构建):
文档 → 切块 → FAISS 向量库 + BM25 倒排索引
检索层(每次问答):
问题 → FAISS Top-5 + BM25 Top-5 → RRF 融合 → Top-5
生成层(每次问答):
Top-5 文档 + 问题 → 拼 Prompt → DeepSeek-R1 → 答案
三条实际经验:
- 混合检索比单一检索稳。两路各发挥所长,比单独用向量或 BM25 都抗造
- RRF 算法简洁有效。不用手调权重,排名本身就能说明问题
- 索引持久化很重要。构建一次,之后每次问答直接加载,不浪费算力
整个项目大约 300 行 Python 代码,覆盖了现代 RAG 系统的核心链路。从这出发,你可以接更多数据源、加多轮对话、加重排序模型,完全取决于你想解决什么问题。
项目地址:https://github.com/helloworldtang/langchain-rag-tutorial
常见问题(FAQ)
为什么RAG要使用混合检索而不是单用向量检索或BM25?
纯向量检索靠语义,但专有名词和精确短语易漏;纯BM25做关键词匹配,不理解同义词。混合检索结合两者,用RRF融合排名,兼顾精确和语义,效果更稳。
RRF倒数排名融合算法是怎么工作的?
RRF将多路检索结果的排名倒数相加,分数越高越靠前。文章说实现只有十来行,但能有效融合BM25和向量检索的排名,比单独调优更稳定。
如何用Ollama和LangChain搭建本地RAG系统?
安装uv和Ollama,拉取deepseek-r1和nomic-embed-text模型,克隆项目并执行uv sync。核心代码用自定义类适配Ollama,实现文档加载、切块、混合检索和LLM生成。
版权与免责声明:本文仅用于信息分享与交流,不构成任何形式的法律、投资、医疗或其他专业建议,也不构成对任何结果的承诺或保证。
文中提及的商标、品牌、Logo、产品名称及相关图片/素材,其权利归各自合法权利人所有。本站内容可能基于公开资料整理,亦可能使用 AI 辅助生成或润色;我们尽力确保准确与合规,但不保证完整性、时效性与适用性,请读者自行甄别并以官方信息为准。
若本文内容或素材涉嫌侵权、隐私不当或存在错误,请相关权利人/当事人联系本站,我们将及时核实并采取删除、修正或下架等处理措施。也请勿在评论或联系信息中提交身份证号、手机号、住址等个人敏感信息。