GEO 检查工具 10 月更新:llms.txt 权重 4→2,把分数还给 SSR
AIAI Summary (BLUF)
GEO 检查工具 10 月更新已完成:llms.txt 权重从 4 分降至 2 分,释放的 2 分转移给 SSR 可解析性(4→6),可抓取性维度总分 20 分不变。llms.txt 检测升级为 llmstxt.org 规范四要素分级评分,并新增链接可发现性检测。抓取失败归因细化为 15 个网络错误码、HTTP 430 专属建议与反爬壳页识别;分析接口引入并发去重与 90 秒硬超时;分享激励修复同
GEO 检查工具(/tool)在九月升级之后,又完成了一轮以「校准」和「可靠」为主线的更新。这一轮没有堆新功能,重点做三件事:把评分模型里被高估的项调回真实权重、把抓取失败的原因说清楚、让并发与分享激励的边界行为不再出错。以下是本次更新的完整内容。
一、模型校准:llms.txt 权重从 4 分降到 2 分
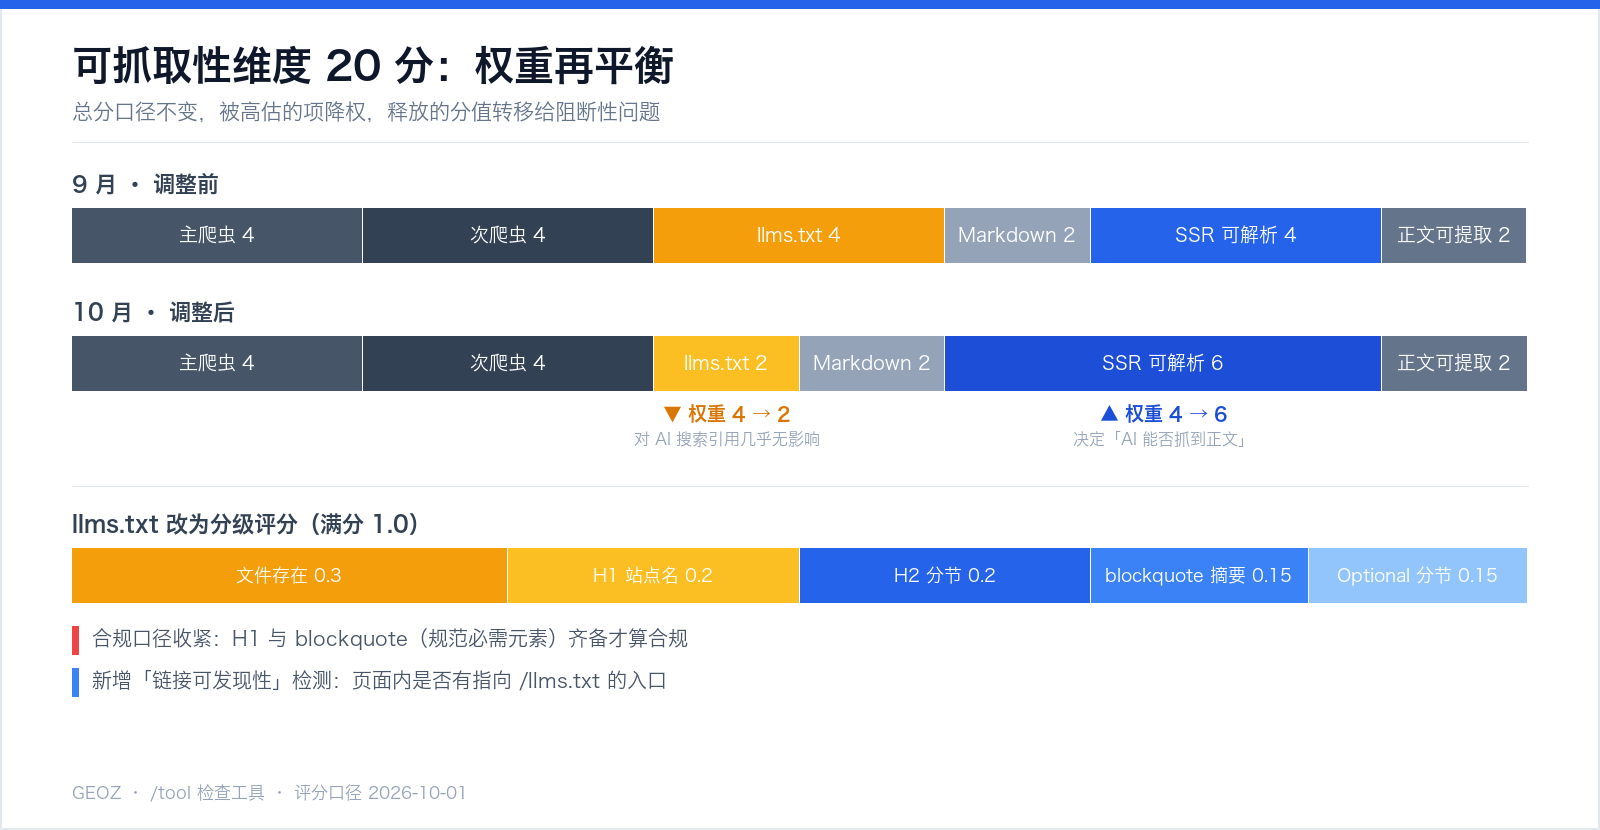
九月我们给 llms.txt 留了 4 分权重(可抓取性维度 20 分里的五分之一)。十月,我们把它调到 2 分,释放出的 2 分转移给 SSR 可解析性(4 → 6)。可抓取性维度总分 20 分不变。
这不是拍脑袋,是三组实测数据的结果:
| 证据来源 | 数据 |
|---|---|
| Limy.AI 爬虫请求统计 | 5.15 亿次请求中,/llms.txt 仅被请求 408 次(约 0.00008%) |
| Ahrefs 域名抽样 | 13.7 万域名中 28% 已部署 llms.txt,其中 97% 在一个月内零请求 |
| Google 官方 GEO 指南(2026-05-15) | 明确表示「不需要创建新的机器可读文件」 |
但 llms.txt 并非全无价值:Vercel 与 ora.ai 对 1,033 次 agent 运行实测显示,AI 编程助手 / Agent 场景存在真实消费——86% 的 llms.txt 抓取是经站内链接到达的,36% 会进一步抓取文件里列出的页面。所以我们保留评估、只降权重,把分数还给真正的瓶颈项:SSR 可解析性决定「AI 能不能拿到正文」,是阻断性问题。
同时,llms.txt 的检测从「有 H1 就算合规」的布尔判定,升级为 llmstxt.org 规范四要素分级评分:
| 要素 | 分值 |
|---|---|
| 文件存在 | 0.3 |
| H1 站点名 | 0.2 |
| H2 分节链接 | 0.2 |
| blockquote 站点摘要(规范必需元素) | 0.15 |
| Optional 分节 | 0.15 |
合规口径同步收紧:H1 与 blockquote 两个规范必需元素齐备才算合规。报告里的提示也不再是一句「未部署」,而是逐项列出缺少哪些规范要素。另外新增一项链接可发现性检测——如果你的页面(页脚或 head)里没有指向 /llms.txt 的链接,agent 很可能根本发现不了它。
顺带清理了两处历史包袱:
- 移除了 llms-full.txt 探测。该文件按定义是「完整版」大文件,而探测受 6 秒单跳超时与 256KB 上限约束——实测 5 个真实站点有 3 个必然失败。它在本地与生产库里从未落过一条数据,却让每次分析白付最多 6 秒。
- 删掉了「llms.txt 已被 Chrome Lighthouse 纳入 agentic browsing 审计」的表述。这句话夸大了行业采纳度。
分数变了,但你得知道是为什么
模型口径调整有一个副作用:同一个站点什么都没改,分数也可能变。所以报告页新增了「口径变更提示」——当某次模型调整的生效日期落在你「上次分析 → 本次分析」之间时,对比区会明确提示「这次分数变化可能部分来自评分模型调整」;评分明细标题则常驻展示当前报告所用的口径日期。我们把每一次影响分数的调整都记入一份清单,不会再出现「分数降了却不知道是谁改的」。
二、抓取失败不再是一句「获取页面失败」
过去失败报告只有一句笼统的兜底文案,用户不知道该改什么。本次把失败原因拆到可执行的粒度:
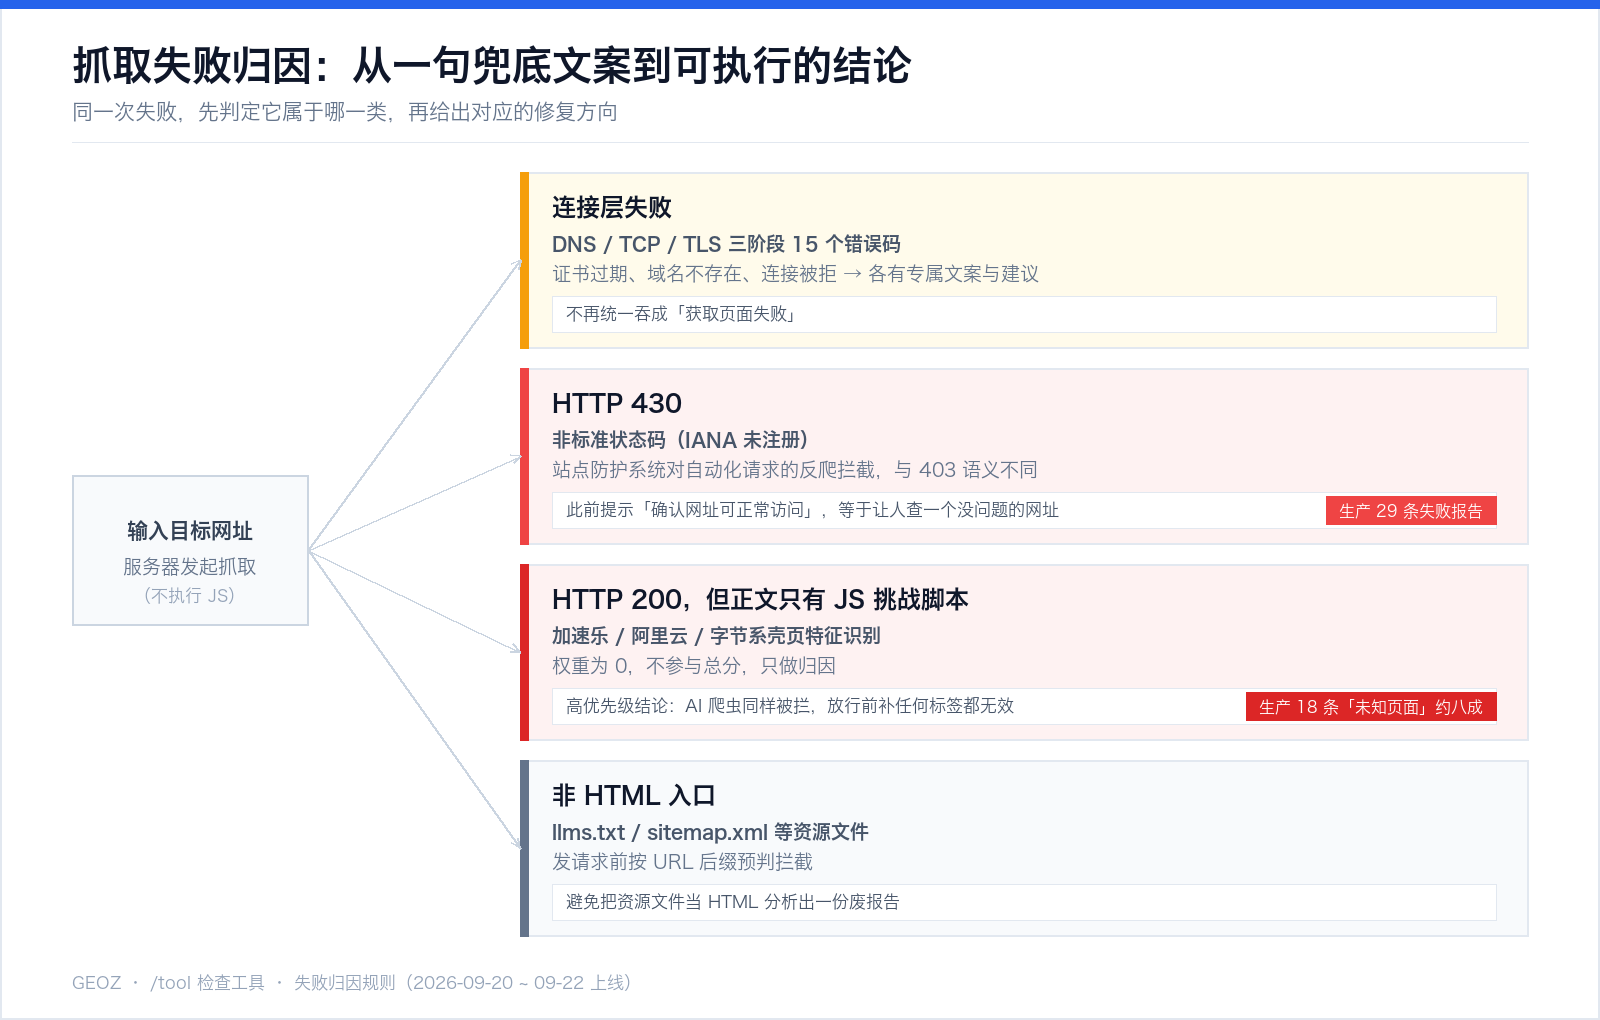
- 15 个网络错误码映射为可读文案,覆盖 DNS / TCP / TLS 三个阶段(证书过期、域名不存在、连接被拒等)。实现上会递归下钻 Node fetch 的
cause链与AggregateError,而不是一律吞成「获取页面失败」。 - HTTP 430 专属建议。430 是非标准状态码(IANA 未注册,见于 Shopify 生态与部分 WAF/CDN),语义是站点防护系统对自动化请求的反爬拦截,和 403 的「没有访问权限」完全不同。此前它落进通用 4xx 分支,提示用户「确认网址可正常访问」——等于让人去检查一个本来就没问题的网址。生产库里 29 条失败报告正是这个原因。
- 反爬壳页识别。生产 18 条「未知页面」报告里约八成是这类:HTTP 200、HTML 头合法,但正文只有一段 JS 挑战脚本(加速乐
js_clearance、阿里云acw_sc__v2、字节系_$jsvmprt)。这种情况的修复方向是 WAF 配置,不是补 title。报告现在会直接给出高优先级结论:AI 爬虫不执行 JavaScript 且同样被 WAF 拦截,页面对 AI 完全不可见——在放行爬虫之前,补任何标签都没有意义。这一项权重为 0,不参与总分计算,只做归因。 - 标题四级降级链:
<title>→og:title→ 首个 H1 → 域名,解决「未知页面」标题毫无信息量的问题。但有个刻意约束:降级值只用于展示,标题质量判分只认原生<title>,否则降级值会掩盖「站点缺 title」这个真实的 GEO 不合格项。判定来源会在明细里透明标注。 - 非 HTML 入口预判:发请求前就按 URL 后缀拦掉 llms.txt / sitemap.xml 这类数据文件,避免拿资源文件当 HTML 分析出一份废报告。
- SSR 检测补盲区:引入脚本总字符数(
scriptChars),修复「只有 1–2 个超大脚本」的站点不命中scriptCount > 8计数盲区的问题。
三、同一个网址点两次,不该扣两次配额
前端双击、多开标签、自动重试,都会发出同 IP + 同 URL 的并发请求。此前它们各自跑完整链路——配额扣 N 次、落 N 行报告、大模型触发 N 次。
现在引入了进程内 in-flight 去重:以「IP 哈希 + URL 归一化变体」为键(协议、www、末尾斜杠差异都会被抹平),第一个请求作为 leader 执行完整链路,后续请求复用同一个 Promise,并按各自的付费墙状态返回结果。任务结束(含失败)自动出表,另有 3 分钟 TTL 兜底。
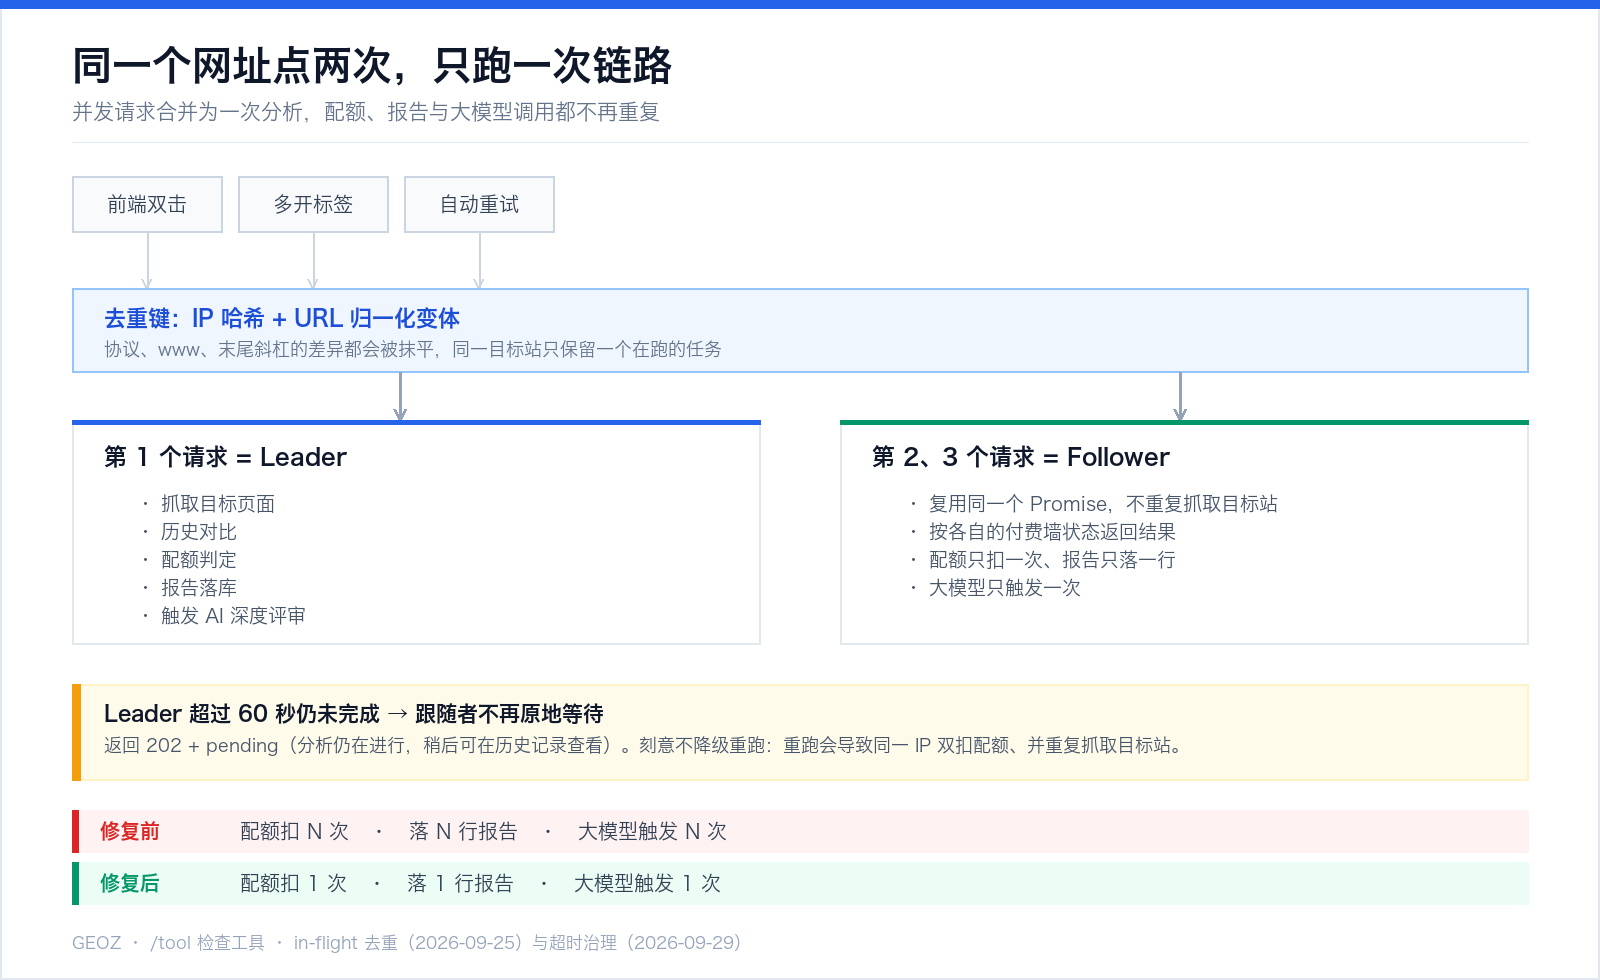
去重本身也带来两个风险,我们一并处理了:
- leader 挂死传染跟随者:跟随者的等待加了 60 秒上限,到点不重跑,而是返回
202 + pending,告诉用户分析仍在进行、稍后可在历史记录查看。不重跑是刻意的——重跑会导致同一 IP 双扣配额、并重复抓取目标站。 - 前端无限转圈:三个调用点统一接入新的请求助手,90 秒硬超时(刻意大于服务端 60 秒等待上限,保证用户看到的是「仍在分析」而不是浏览器层报错),并加了阶段进度文案:抓取目标页面 → 逐项检查页面结构 → 生成检测报告。
同时补上了链路耗时观测日志(抓取 / 落库 / 总耗时,超过 60 秒标记 slow),以及 PM2 多实例启动告警——进程内去重只在单实例部署下成立,切到 cluster 会静默失效,这个坑必须提前喊出来。
四、分享激励的公平性修复
九月上线的分享解锁有一个明显的边界错误:为防自刷设的「同 IP 不计入」规则,把同一网络下的好友访问全部误杀了。生产数据显示,规则上线 10 天,0 条有效访问;唯一一次真实分享,4 台设备全部被拦。
改法是:访问全量落库(并标注自访),解锁门槛放宽为「任意去重访客」,防滥用交给另外三层——终身一次、每日配额、接口限流;分享者的奖励额度则继续按严格的「不同 IP」口径发放。同时好友页新增了助力成功提示,不再静默失败。
五、报告页:达 A 值得庆祝一下
如果这是你第一次把站点做到 A 级,报告页会放一场烟花,并展示等级阶梯的爬升动画;如果只是守住了 A,就轻量撒花。判定在分析时点完成并内嵌进报告 JSON,历史取数上限从 50 提到 200,避免分析次数多的网址被误判成「首次达 A」。命中 24 小时冷却时,横幅改为降级展示,而不是整块消失。
「与上次对比」区也做了重构:新增变化叙事头行(上次分数 → 升降徽章 → 本次分数 · 第 N 次检测)与场景化副行,历史点线升级为走势 sparkline,并首次接入「哪些检查项改善了、哪些退步了」的逐项明细,以及五维分数的哑铃行对比——能直接看出分数变化发生在哪一维。
六、继续吃自己的狗粮:/tool 页 58.1 → 84.0
我们把这套 v2 模型用在了 /tool 页自己身上。初始 HTML 侧加权分 58.1,按报告逐项修复后到 84.0:
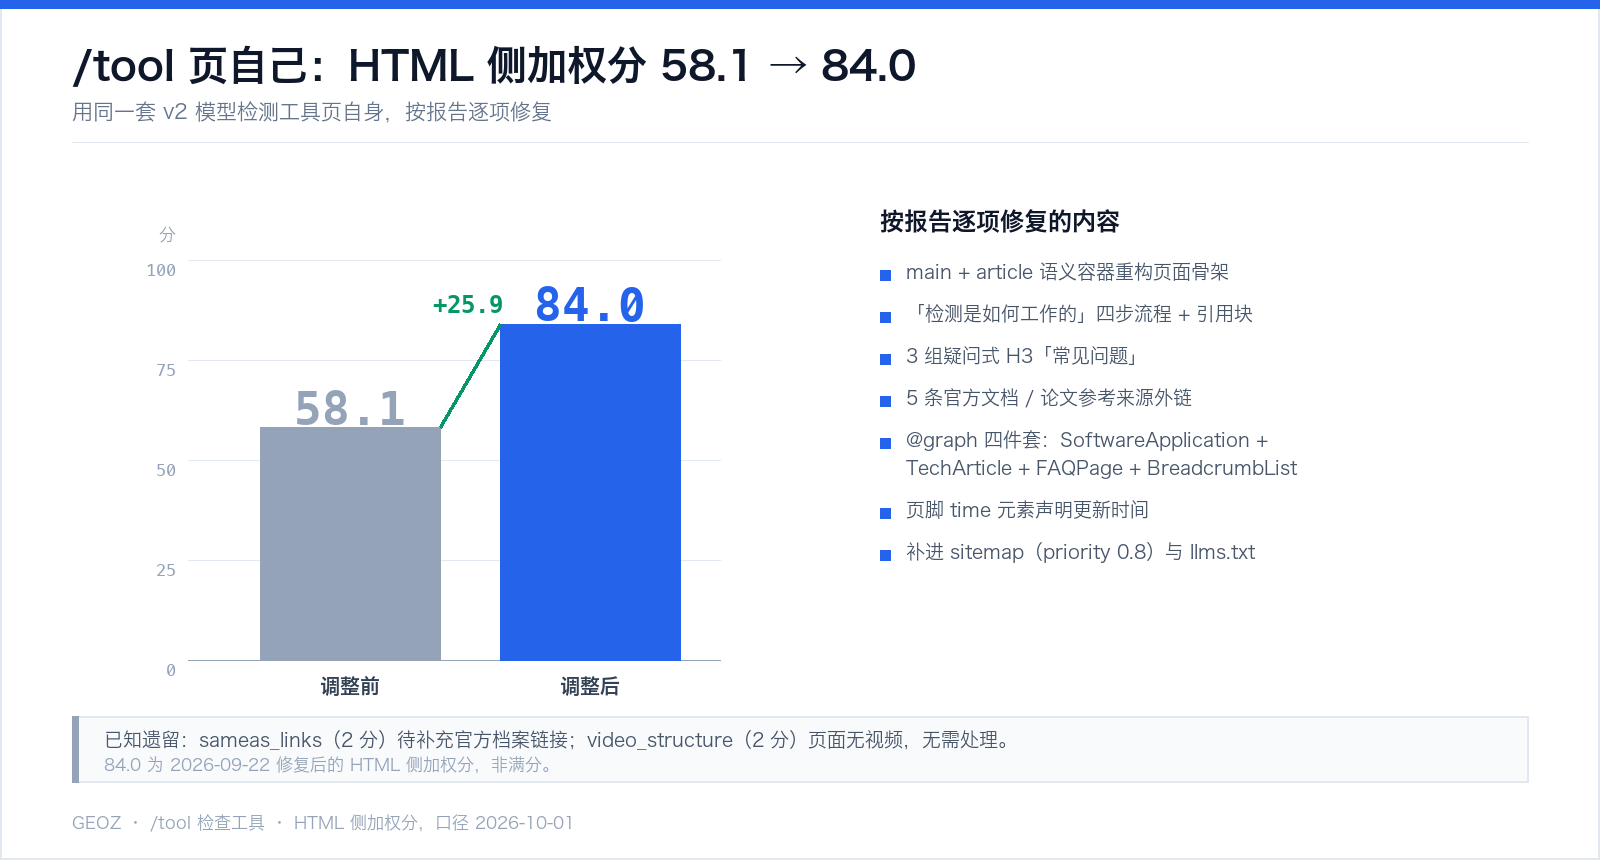
- 用
main+article语义容器重构页面骨架; - 补「检测是如何工作的」四步流程与引用块(引用 arXiv:2311.09730),补三组疑问式 H3 常见问题,补 5 条官方文档 / 论文参考来源,页脚加
time元素声明更新时间; - 结构化数据从单一类型扩为
@graph四件套:SoftwareApplication + TechArticle + FAQPage + BreadcrumbList,并补齐 canonical 与完整的 openGraph / twitter 字段; - FAQ、参考来源、内容日期收敛到单一数据源,保证结构化数据与页面可见内容严格一致——结构化数据和页面上能读到的东西对不上,本身就是一条不可信的信号;
- /tool 补进 sitemap(priority 0.8)与 llms.txt 的 Site Structure,一级导航「最新文章」也换成了「GEO 分析工具」,直接指向工具页。
工具页还上线了一块**「最常见的 GEO 缺陷」**榜单:基于近 30 天完整检测的聚合数据,展示最普遍未通过的检查项。它只返回百分比,不包含任何被检测的域名、URL 或用户信息。榜单采用白名单制,只收录「普遍适用且用户可自行修复」的项——llms.txt 本次也被移出榜单:它不是普遍缺陷,继续挂在榜上等于把一个影响有限的长尾项包装成高优先级问题,会误导用户的投入顺序。原始检测结果仍在报告的「评分明细」里如实展示。
结语
这一轮更新的共同点,是让工具说的话更站得住:分数该降的降、失败该说清的说清、边界该修的修。评分模型与检查项会持续迭代,欢迎在使用中反馈误判与建议:
—— GEOZ 团队,2026 年 10 月
版权与免责声明:本文仅用于信息分享与交流,不构成任何形式的法律、投资、医疗或其他专业建议,也不构成对任何结果的承诺或保证。
文中提及的商标、品牌、Logo、产品名称及相关图片/素材,其权利归各自合法权利人所有。本站内容可能基于公开资料整理,亦可能使用 AI 辅助生成或润色;我们尽力确保准确与合规,但不保证完整性、时效性与适用性,请读者自行甄别并以官方信息为准。
若本文内容或素材涉嫌侵权、隐私不当或存在错误,请相关权利人/当事人联系本站,我们将及时核实并采取删除、修正或下架等处理措施。也请勿在评论或联系信息中提交身份证号、手机号、住址等个人敏感信息。