网站内容正常却搜不到?可能是 robots.txt 把 AI 爬虫挡在门外了
AIAI Summary (BLUF)
很多网站内容正常却无法被豆包、DeepSeek、Kimi等AI搜索引用,根源往往是robots.txt误拦了AI爬虫。本文汇总2026年国内主流AI引擎的爬虫User-Agent,提供可直接复制的AI友好配置模板,并梳理三类高频错误配置和完整校验流程,帮开发者快速完成网站对AI爬虫的适配。
核心洞察
很多站点流量掉得莫名其妙,查来查去发现是 robots.txt 里一行 Disallow: / 把 AI 爬虫全挡了。这事儿的荒诞之处在于:你花大力气做内容、做结构化,结果 AI 连门都进不来。另外提醒一句,文中的 UA 列表建议自己再去各家官方文档核对一遍,厂商改标识从来不通知你。
核心结论
网站内容在豆包、DeepSeek、Kimi 等 AI 搜索产品中无法被引用的常见根源是
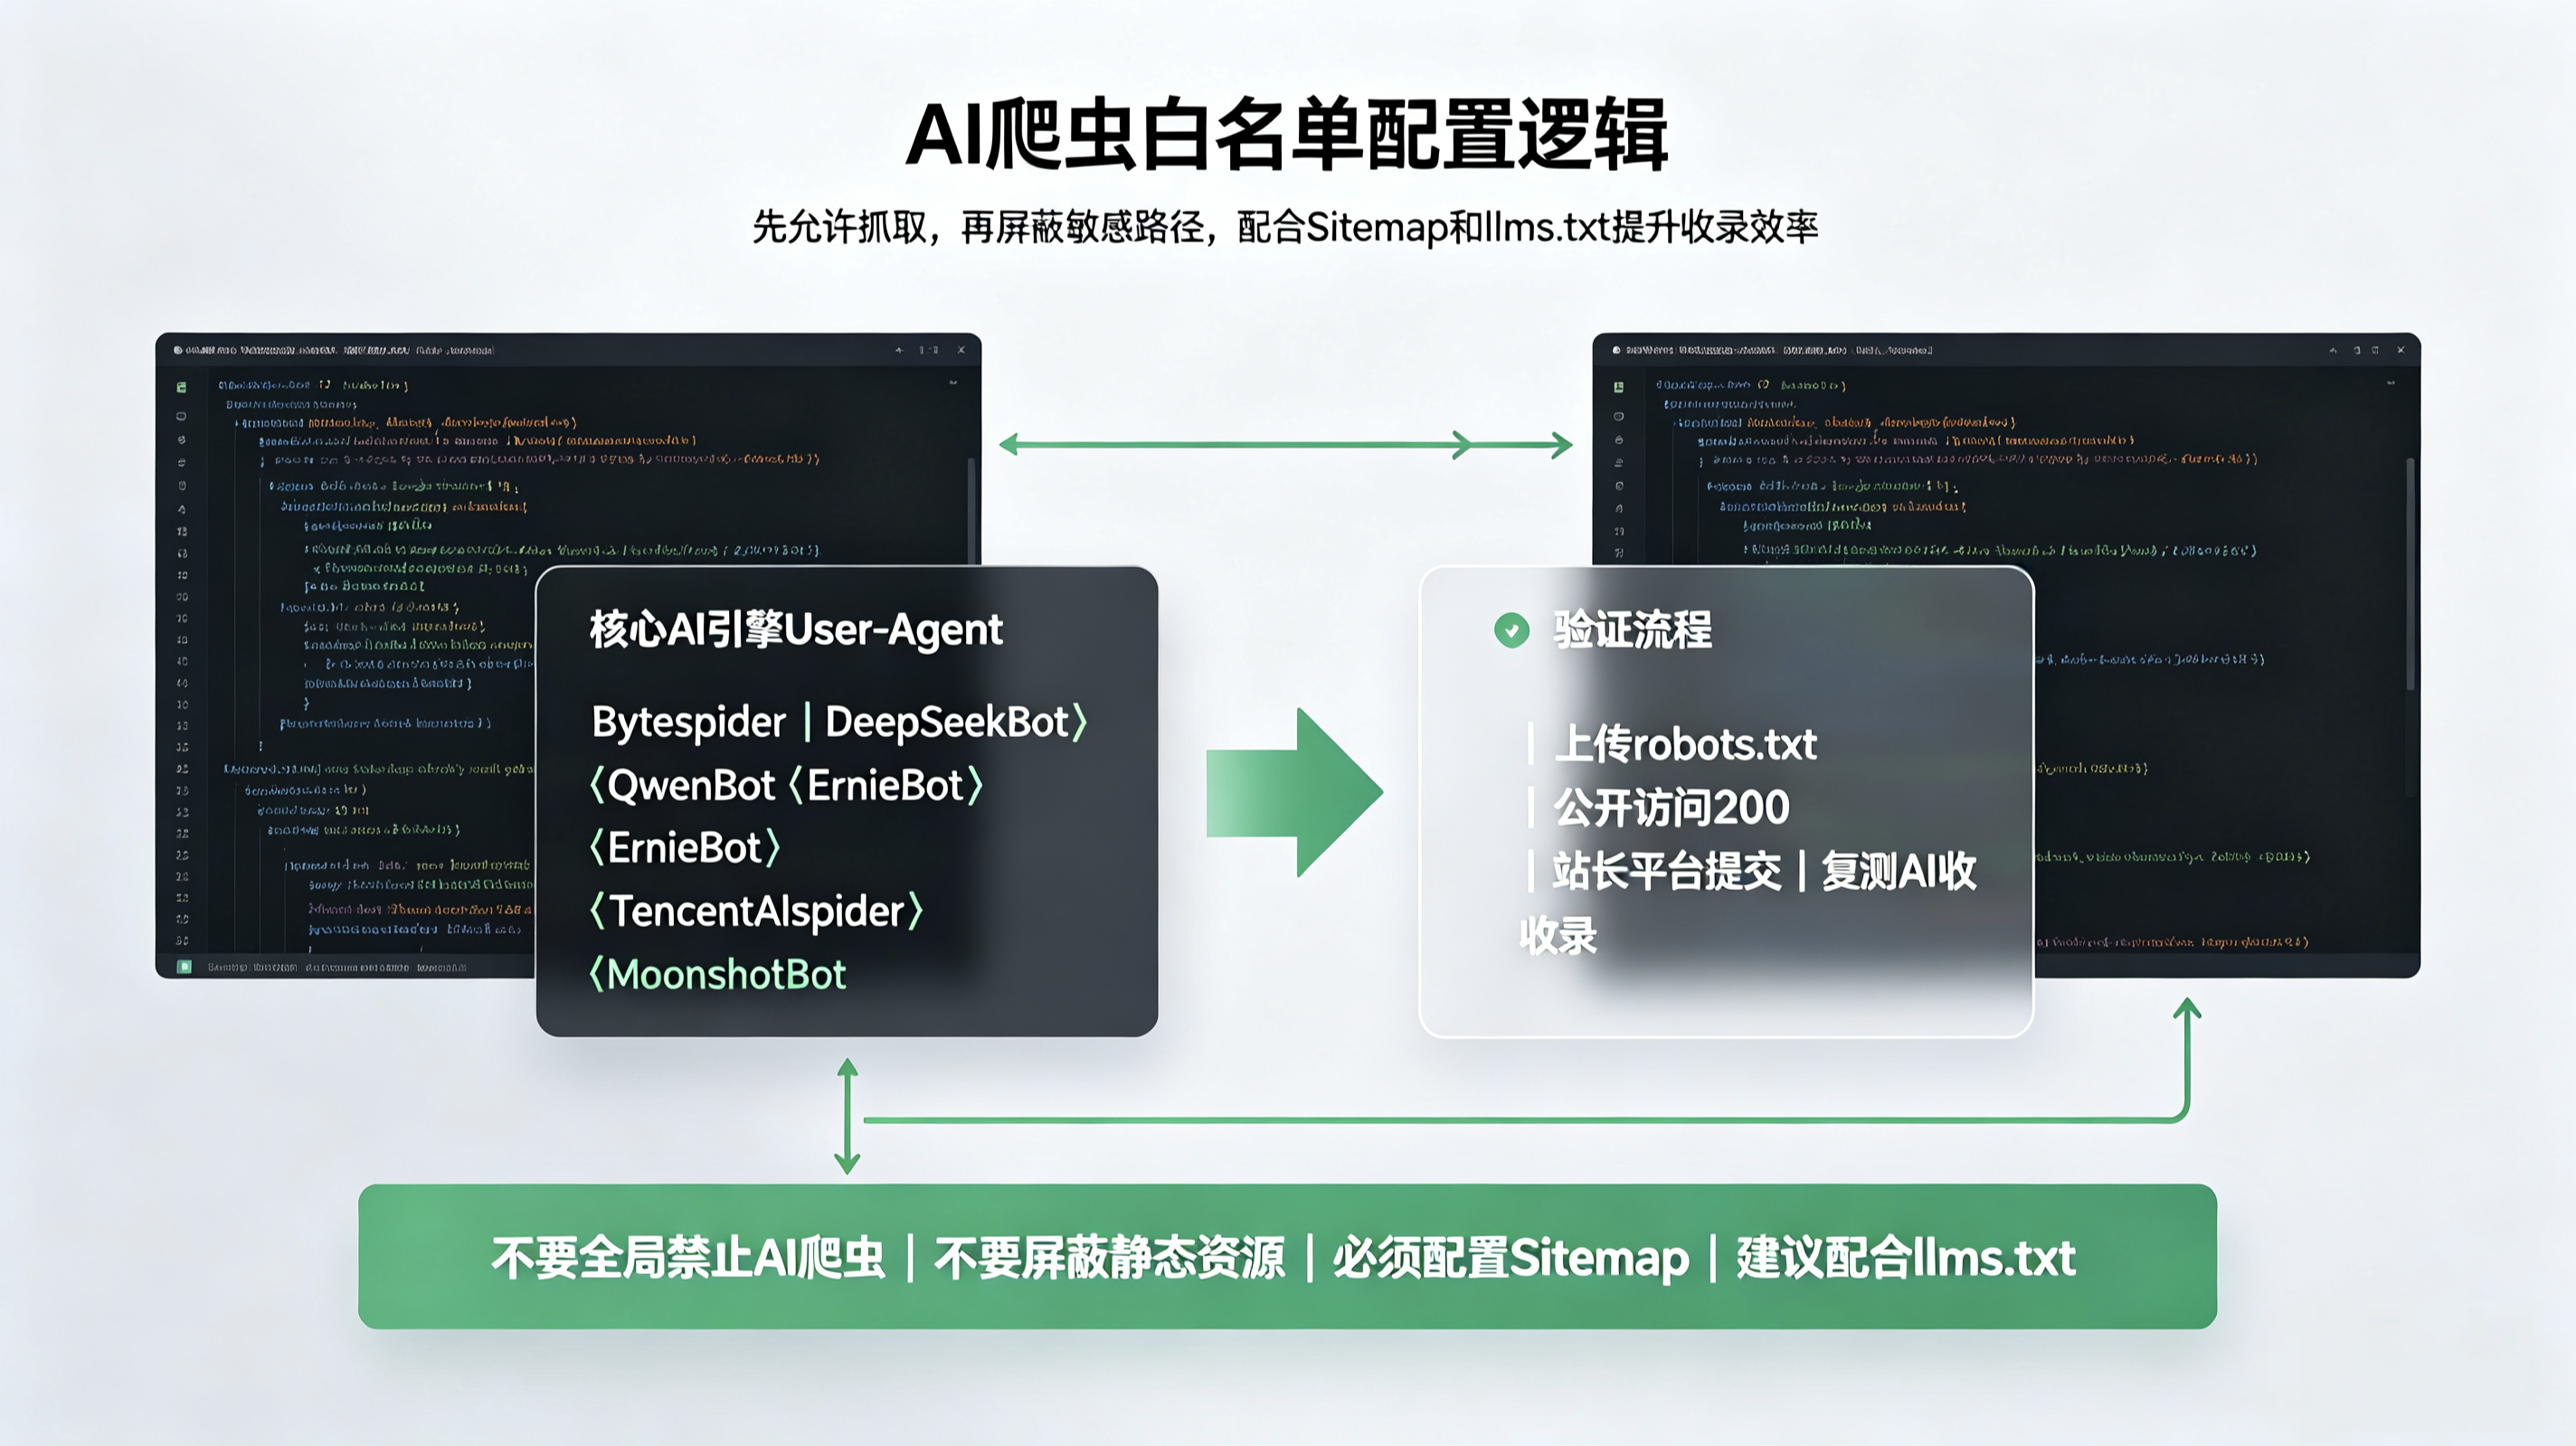
robots.txt配置不当,意外拦截了 AI 爬虫抓取。国内主流 AI 引擎爬虫 User-Agent 分别为:豆包 Bytespider、DeepSeek DeepSeekBot、通义千问 QwenBot、文心一言 ErnieBot 与 BaiduSpider-AI、腾讯元宝 TencentAIspider、Kimi MoonshotBot。
高频错误配置包括:全局拦截仅放行传统搜索引擎、拦截 CSS/JS/图片静态资源、缺少 Sitemap 与 llms.txt 配置,三者均会直接降低 AI 对站点内容的抓取与识别效果。
配置完成后应通过四步验证:浏览器访问确认返回 200 状态码、使用搜索引擎工具校验语法、在 AI 站长平台提交 Sitemap、等待 1-2 周后检索品牌关键词观察引用情况。
敏感目录不应将完整路径写入 robots.txt,因为恶意爬虫不会遵守该协议,敏感资源应依靠服务器权限与鉴权限制访问。
前言
不少网站运维人员遇到过这样的现象:网站内容质量正常,但在豆包、DeepSeek、Kimi 等 AI 搜索产品中完全无法被引用。排查后发现根源是 robots.txt 配置不当,意外拦截了 AI 爬虫抓取。
AI 搜索逐步成为信息获取的重要入口,合理编写 robots.txt,放行合规 AI 爬虫,已经是网站面向大模型生态的基础技术配置。本文整理国内主流 AI 爬虫 User-Agent,提供可直接复制的配置模板、典型错误案例以及完整校验流程,帮助开发者完成网站对 AI 爬虫的适配。
一、为什么需要单独针对 AI 爬虫配置 robots 规则?
传统 SEO 场景下,robots.txt 配置主要面向 Googlebot、Baiduspider 这类传统搜索引擎爬虫。AI 搜索拥有独立的爬虫 UA,很多网站沿用旧的配置文件,要么没有显式放行 AI 爬虫,要么设置了过于严格的全局拦截规则,直接导致大模型无法抓取页面公开内容。
想让大模型引用站点公开信息,前提是 AI 爬虫可以正常访问网页。robots.txt 是爬虫访问站点读取的第一个文件,这个文件配置出错,后续内容建设、结构化标记等工作效果都会大打折扣。
二、2026 国内主流 AI 引擎爬虫 User-Agent 汇总
提示:各厂商会迭代更新爬虫标识,建议每季度查阅各平台官方文档核对 UA 列表。
| AI 产品 | 爬虫 User-Agent |
|---|---|
| 豆包 | Bytespider |
| DeepSeek | DeepSeekBot |
| 通义千问 | QwenBot |
| 文心一言 | ErnieBot、BaiduSpider-AI |
| 腾讯元宝 | TencentAIspider |
| Kimi | MoonshotBot |
三、标准 robots.txt AI 友好配置模板
下面是适用于绝大多数企业官网的 AI 友好配置,放行主流 AI 爬虫与传统搜索引擎,同时屏蔽后台、接口等不需要公开抓取的路径。
# robots.txt AI爬虫适配配置
# Update time: 2026-08-12
# 默认规则:允许合规爬虫访问全部公开路径
User-agent: *
Allow: /

# ------------------------------
# 国内主流AI爬虫,显式允许抓取
# ------------------------------
User-agent: Bytespider #豆包
Allow: /

User-agent: DeepSeekBot #DeepSeek
Allow: /

User-agent: QwenBot #通义千问
Allow: /

User-agent: ErnieBot #文心一言
Allow: /

User-agent: BaiduSpider-AI #文心一言补充爬虫
Allow: /

User-agent: TencentAIspider #腾讯元宝
Allow: /

User-agent: MoonshotBot #Kimi
Allow: /

# ------------------------------
# 海外AI爬虫(按需开启,无海外业务可以注释)
# ------------------------------
User-agent: GPTBot #ChatGPT
Allow: /

User-agent: ClaudeBot #Claude
Allow: /

User-agent: PerplexityBot #Perplexity
Allow: /

# ------------------------------
# 传统搜索引擎爬虫标准配置
# ------------------------------
User-agent: Googlebot
Allow: /

User-agent: Baiduspider
Allow: /

User-agent: Bingbot
Allow: /

User-agent: Sogou web spider
Allow: /

User-agent: 360Spider
Allow: /

# ------------------------------
# 禁止抓取的内部路径,按站点实际情况修改
# ------------------------------
Disallow: /admin/ #后台管理目录
Disallow: /api/ #接口目录
Disallow: /private/ #私有内容目录
Disallow: /tmp/ #临时文件目录
# Disallow: /*?* #可选,屏蔽带参数重复页面
# Disallow: /search #可选,屏蔽站内搜索页

# ------------------------------
# 填写站点地图真实地址
# ------------------------------
Sitemap: https://你的域名/sitemap.xml

# ------------------------------
# llms.txt为AI爬虫专用说明文件,部署于网站根目录
# 用于向大模型输出站点主体、业务、FAQ等标准化信息,提升识别准确率
# ------------------------------
四、3 类高频错误配置
错误 1:全局拦截爬虫,仅放行传统搜索引擎
部分站点为防范恶意采集设置 User-agent: * Disallow: /,之后只放行百度、谷歌爬虫,遗漏全部 AI 爬虫 UA。该配置会直接导致所有 AI 引擎无法抓取网站,站点内容无法出现在 AI 回答中。
修复方案:采用默认放行、局部禁止的写法;或者把全部 AI 爬虫 UA 增加独立 Allow: / 规则。
错误 2:拦截 CSS、JS、图片静态资源
AI 爬虫和传统搜索引擎一样,需要读取样式、脚本、图片资源完成页面渲染解析。如果配置中拦截 /static/、主题目录等静态资源路径,爬虫无法完整解析页面,会降低内容识别效果。
修复方案:除非静态目录存放敏感内容,否则不要拦截静态资源路径。
错误 3:缺少 Sitemap 与 llms.txt 配置
Sitemap 帮助爬虫快速遍历全站页面;llms.txt 是面向大模型的专用说明文件,相当于给 AI 阅读的站点简介。二者可以显著提升抓取效率与实体识别准确度,属于面向大模型生态的必备配套配置。
五、配置完成后的验证手段
修改 robots.txt 之后必须校验规则是否真正生效:
- 文件访问校验:浏览器直接访问
https://你的域名/robots.txt,确认返回 200 状态码,展示最新配置内容。 - 搜索引擎工具校验:Google 搜索控制台、百度搜索资源平台均提供 robots.txt 检测工具,可以校验语法与规则逻辑。
- AI 站长平台校验:豆包、文心一言、通义千问的站长后台,完成站点所有权验证后提交 Sitemap,主动触发爬虫访问。
- 效果观测:配置完成等待 1-2 周,使用各大 AI 产品检索站点品牌、业务关键词,观察是否可以正常引用官网信息。收录存在时间周期,不要刚修改就立刻测试。
六、进阶优化建议
- 根目录部署
llms.txt,使用简洁客观的结构化文本输出主体信息,和放行 AI 爬虫的 robots 配置配合,提升大模型信息引用准确率。 - 页面部署 JSON-LD(Schema.org)实体标记,帮助大模型快速识别企业主体信息。
- 每季度复核
robots.txt,跟进新增 AI 爬虫 User-Agent,及时更新规则列表。 - 不要把敏感目录完整路径写在 robots.txt 中。恶意爬虫不会遵守 robots 协议,反而会直接扫描 Disallow 内的路径。敏感资源应当依靠服务器权限、鉴权来限制访问,不能单纯依赖 robots.txt 拦截。
常见问题(FAQ)
为什么我的网站内容正常,却无法被豆包、DeepSeek等AI搜索引用?
根源往往是robots.txt误拦了AI爬虫。很多站点沿用旧配置,只放行传统搜索引擎,遗漏了AI爬虫UA,或设置了全局拦截规则,导致大模型无法抓取页面公开内容。
2026年国内主流AI引擎的爬虫User-Agent有哪些?
豆包是Bytespider,DeepSeek是DeepSeekBot,通义千问是QwenBot,文心一言是ErnieBot和BaiduSpider-AI,腾讯元宝是TencentAIspider,Kimi是MoonshotBot。建议每季度核对官方文档。
配置完robots.txt后,如何验证AI爬虫能否正常抓取?
先浏览器访问robots.txt确认返回200且内容正确;再用搜索引擎工具校验语法;然后在AI站长平台验证站点并提交Sitemap;等待1-2周后,用AI产品检索品牌词观察引用情况。
版权与免责声明:本文仅用于信息分享与交流,不构成任何形式的法律、投资、医疗或其他专业建议,也不构成对任何结果的承诺或保证。
文中提及的商标、品牌、Logo、产品名称及相关图片/素材,其权利归各自合法权利人所有。本站内容可能基于公开资料整理,亦可能使用 AI 辅助生成或润色;我们尽力确保准确与合规,但不保证完整性、时效性与适用性,请读者自行甄别并以官方信息为准。
若本文内容或素材涉嫌侵权、隐私不当或存在错误,请相关权利人/当事人联系本站,我们将及时核实并采取删除、修正或下架等处理措施。也请勿在评论或联系信息中提交身份证号、手机号、住址等个人敏感信息。