大模型评测不止看榜单:从 MMLU 到 Tiny-RAG 的落地拆解
AIAI Summary (BLUF)
这一章讲的是大模型落地应用的两大关键环节:一是怎么科学评测大模型,包括 MMLU、GSM8K、MATH 等主流评测集以及 Open LLM Leaderboard、Lmsys Chatbot Arena、OpenCompass 等榜单;二是怎么自己动手搭一个 RAG 检索增强生成框架。作者用 Tiny-RAG 为例,从文档加载切分、向量化、检索到大模型生成一步步拆解,帮你把 RAG 的原理和代码都吃透。
核心洞察
先说结论:评测看着像考试排名,实际决定了你能不能放心把模型放进生产环境。RAG 这部分更值得盯,因为它补的是大模型最要命的两个短板:幻觉和知识过期。至于榜单,别只看第一名,任务对不上,分数再高也白搭。
核心结论
- 评测不是简单的考试排名,而是判断大模型能否进入生产环境的关键;RAG 尤其值得关注,因为它直接针对大模型最要命的幻觉和知识过期两个短板。
- 大模型评测必须用标准方法和数据集量化表现,指标不只看准确率,还包括泛化能力、推理速度和资源消耗。
- 主流评测集覆盖多类能力:MMLU 测多学科理解,GSM8K 测小学数学推理,MATH 测更复杂数学,BFCL V2 测复杂工具使用,GPQA 测零样本开放问答。
- 榜单要按任务选择:Hugging Face 开放大模型榜单用于开源模型对比,lmsys Chatbot Arena 基于真实用户对话评测聊天体验,OpenCompass 更关注中文场景;金融、安全、法律、医疗等领域分别有 CFBenchmark、Flames、LawBench、MedBench 等垂直榜单。
- RAG 的核心做法是“先查资料,再回答”,流程分为索引、检索、生成三步;Tiny-RAG 用文档加载切分、向量化、数据库、检索和大模型模块实现,默认切分参数为 max_token_len=600、cover_content=150。
大模型应用
前面几章我们把大模型的基础、训练和微调都过了一遍。这一章换个角度,看它在真实场景里怎么落地。重点有三块:评测、RAG、智能体。
7.1 大语言模型的评测
这几年人工智能发展很快,大规模预训练语言模型成了主角。它们在自然语言处理任务上很能打,但要说清楚一个模型到底行不行,不能靠感觉,得有科学的评测。
大模型评测就是用一套标准方法和数据集,把模型在不同任务上的表现量化出来,再拿去比较。看的指标不止准确率,还包括泛化能力、推理速度、资源消耗。这样你才能知道它在真实场景里有没有应用价值。
大模型开发烧钱,计算资源和数据都是大头,所以评测直接关系到模型值不值得用。评测能告诉你它在哪些任务上靠谱,也能暴露偏见、鲁棒性这些问题,方便后面改。公开公平的评测还让学术界和工业界有个共同标尺,省得各说各话。
7.1.1 大语言模型的评测数据集
评测离不开标准数据集。主流评测集大致分几类,每类盯的东西不一样。
通用评测集
- MMLU:看模型在多学科任务上的理解能力,历史、数学、物理、生物、法律这些都包含,考察知识面和语言理解。
工具使用评测集
- BFCL V2:看模型在复杂工具使用任务里的表现,尤其是多步骤操作的正确性和效率。任务常常要和数据库交互,或者按指令执行操作,贴近真实工具调用。
数学评测集
- GSM8K:小学数学题数据集,测数学推理和逻辑分析。题目包括算术、简单方程、数字推理。题面看着简单,模型得先读懂语义,再做对运算,语言理解和逻辑推理都得过关。
- MATH:更复杂的数学题,代数和几何都有。
推理评测集
- ARC Challenge:科学推理任务,偏常识和科学问题,常见于科学考试题解答、百科问答系统。
- GPQA:零样本条件下回答开放性问题,常见于客服聊天机器人和知识问答。没有特定领域数据时,也得给出合理回答。
- HellaSwag:复杂语境下选最符合逻辑的答案,故事续写、对话生成这类场景会用到。
长文本理解评测集
- InfiniteBench/En.MC:长文本阅读理解,尤其是科学文献理解。学术文献自动摘要、长篇报道分析会用到。
- NIH/Multi-needle:多样本长文档环境里的理解和总结,政府报告解读、企业内部长文档分析这类场景需要处理海量信息。
多语言评测集
- MGSM:不同语言下的数学问题解决能力,看多语言适应性。国际化环境里的数学教育、跨语言技术支持会用到。
这些评测集覆盖的任务很杂,目的就是别让模型只在某一类题上刷分。比如 MMLU 里,有些模型在历史、物理上表现很好,说明多领域知识学得不错。GSM8K 上,新模型在算术和方程求解上已经接近甚至超过一些人类基准。
7.1.2 主流的评测榜单
光有数据集还不够,很多机构会把结果做成榜单。大家看榜单主要是为了少踩坑,知道现在谁跑在前面。
Hugging Face 开放大模型榜单
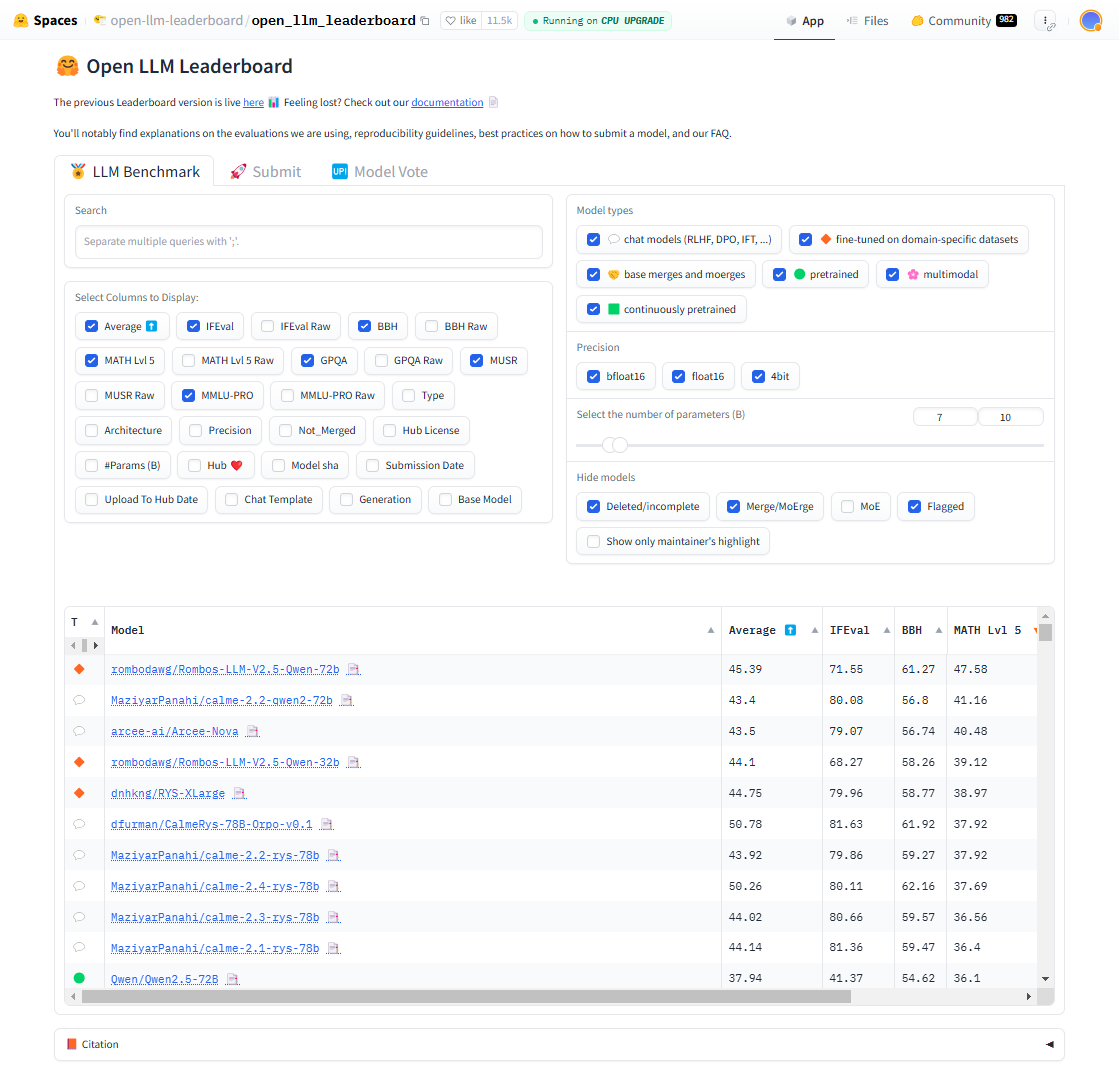
Hugging Face 做的开放榜单,把多个开源大模型放在同一套测试里比。它用多个标准测试集评估,并且持续更新,研究者和开发者经常拿它做对比参考。图 7.1 是页面截图。
lmsys 聊天机器人竞技场榜单
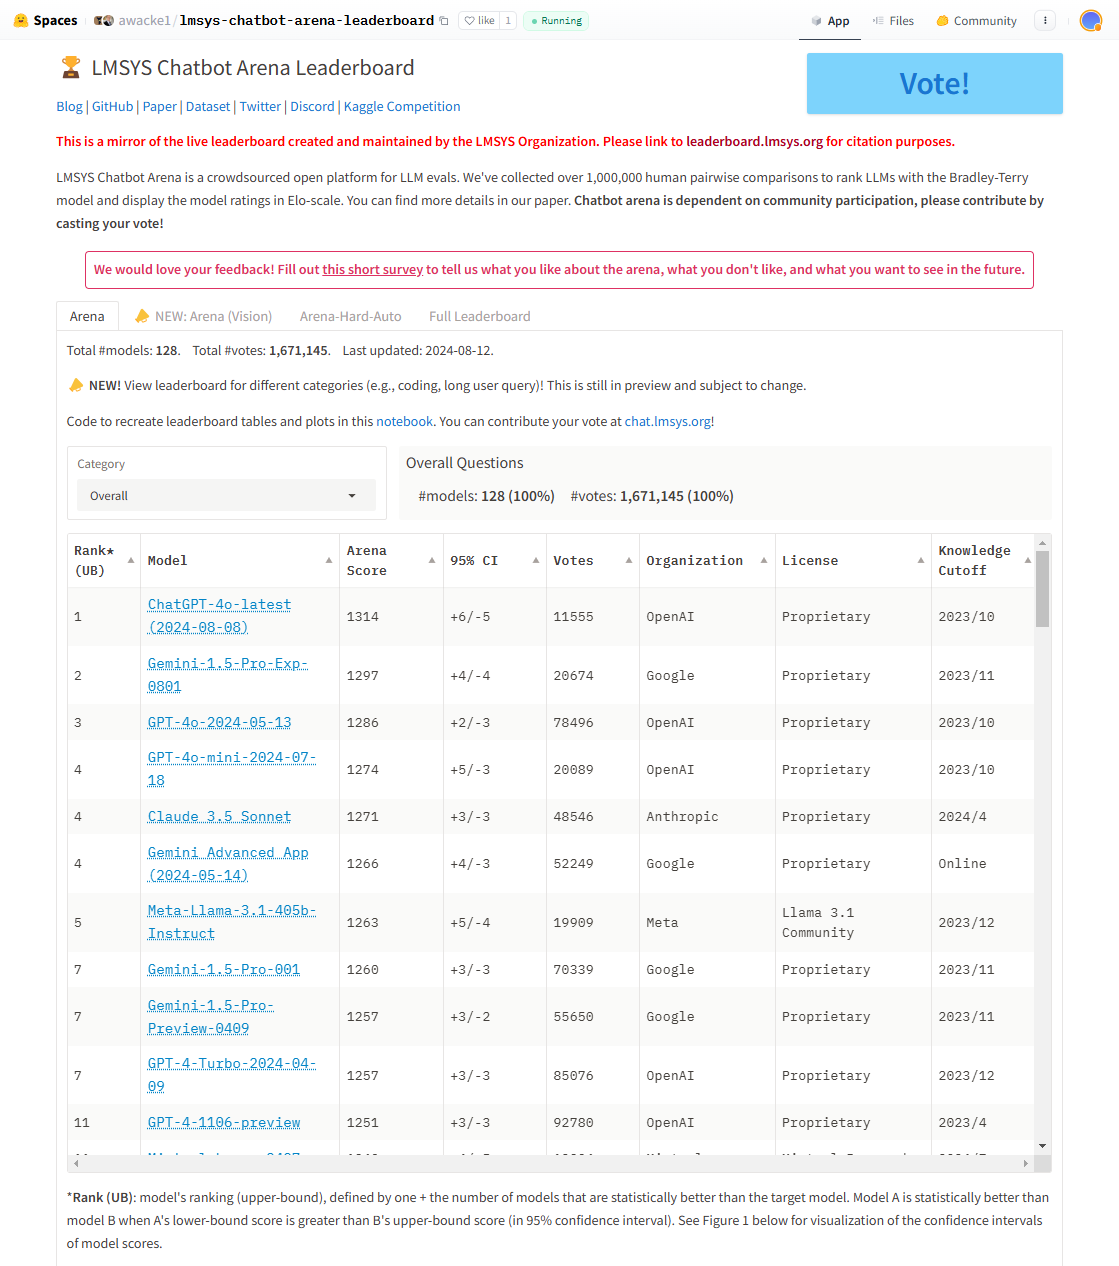
lmsys 的聊天机器人榜单,靠真实用户和模型对话来评测。它看的是自然语言生成、上下文理解、用户满意度这些。想知道一个聊天模型好不好聊,这个榜很有参考价值。看图 7.2。
OpenCompass 中文榜单
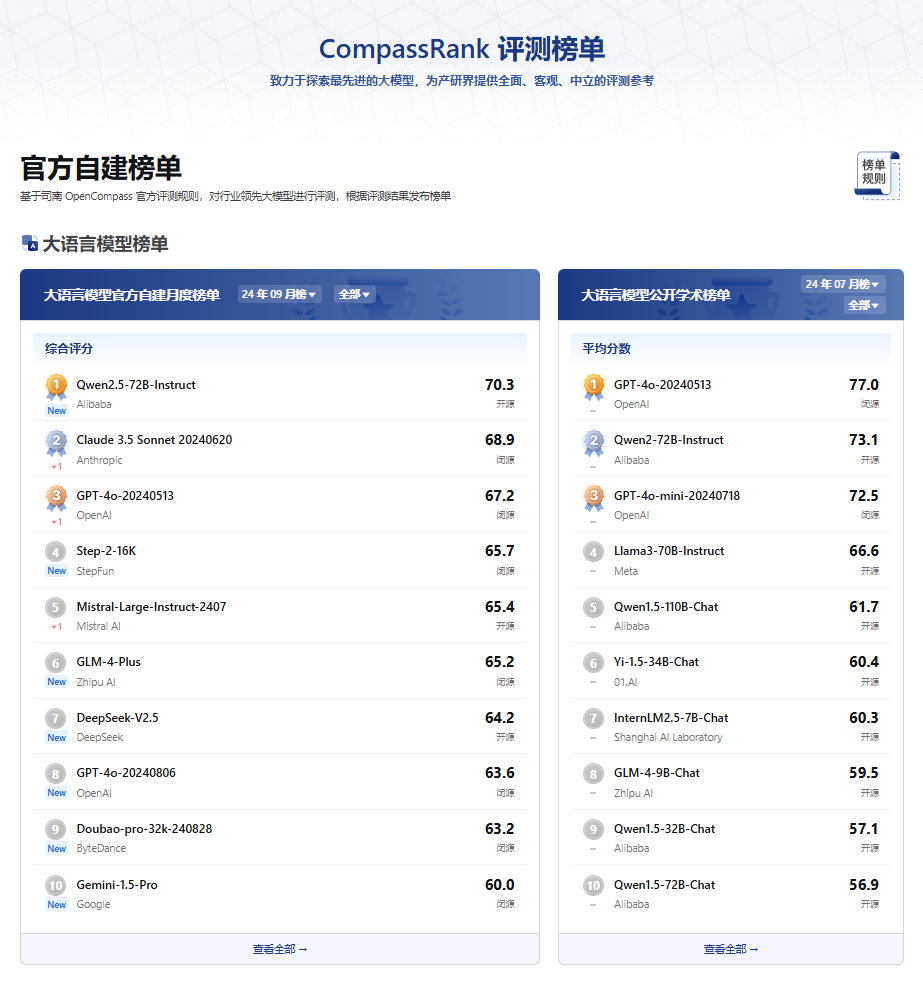
OpenCompass 是国内做的评测榜单,覆盖多种语言和任务,更关注中文场景。它会测中文语言理解和多语言能力,特别看模型在中文语境下的准确性、鲁棒性和适应性。国内企业选模型时,经常会翻这个榜。看图 7.3。
7.1.3 垂直领域的评测榜单
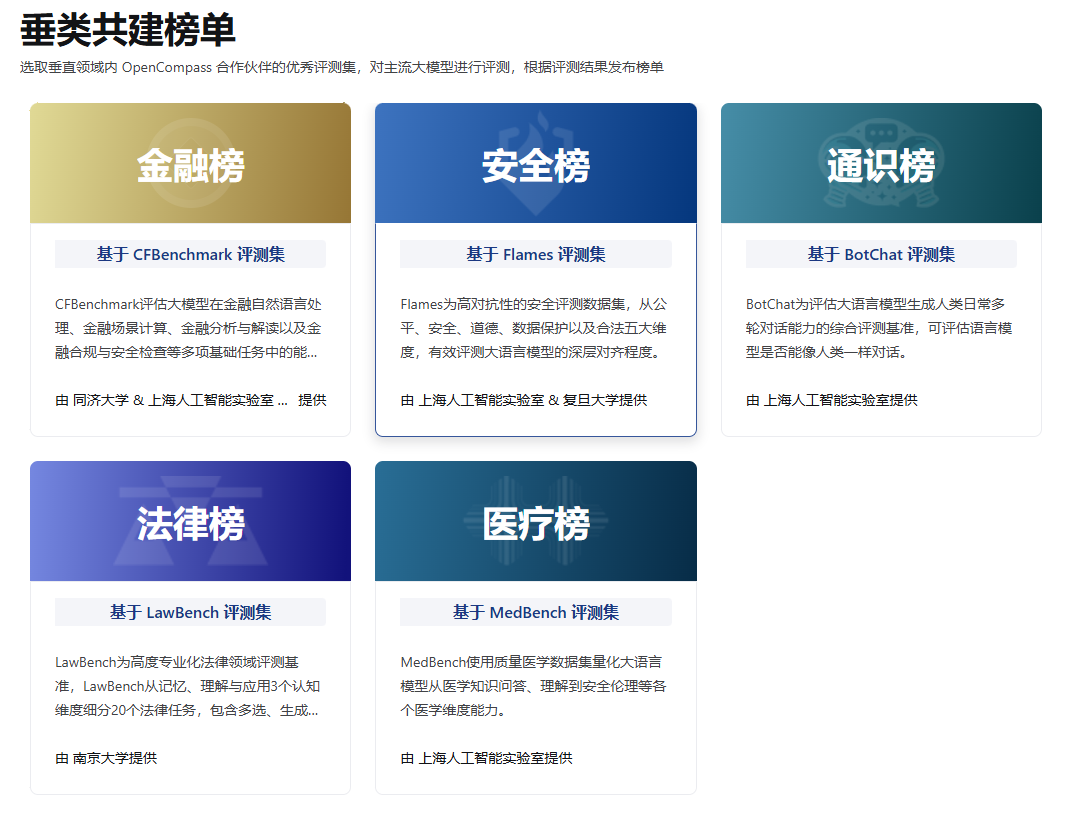
除了通用榜,还有一堆垂直领域榜,专门看某个行业里的能力。图 7.4 是几个例子。
- 金融榜:用 CFBenchmark,评模型在金融自然语言处理、金融预测计算、金融分析与安全检查等任务上的能力。同济大学、上海人工智能实验室和东方财经提供。
- 安全榜:用 Flames,看模型在公平、安全、数据保护、合法五个维度的抗性。上海人工智能实验室和复旦大学提供。
- 通识榜:用 BotChat,评大语言模型生成日常多轮对话的能力,看它像不像人。上海人工智能实验室提供。
- 法律榜:用 LawBench,评法律领域的理解、推理和应用,包括法律问题回答、文本生成、判例分析。南京大学提供。
- 医疗榜:用 MedBench,评医学知识问答、安全伦理理解这些。上海人工智能实验室提供。
7.2 RAG
7.2.1 RAG 的基本原理
大语言模型生成内容时,语言理解和生成能力都很强,但毛病也明显。它有时会编,一本正经地给出错误或误导信息,这就是常说的幻觉。训练数据也可能过时,碰到最新信息,准确性和时效性都难保证。特定领域的专业知识,它处理起来效率也不高,复杂领域知识理解不深。这些问题不解决,模型很难在严肃场景里用。
所以 RAG 出来了。检索增强生成,简称 RAG。你记住它的做法就行:先查资料,再回答。系统先从外部大规模文档库里检索相关信息,把这些信息塞进生成过程,指导模型输出。这样生成的内容更准、更相关,也更容易跟上最新信息。
RAG 干的事,说白了就是先把相关资料找出来,再让模型照着资料回答。用户提问后,检索模块先找相关文本片段,再把这些片段作为附加信息交给语言模型,模型据此生成回答。因为答案建立在真实文档上,幻觉会少一些,答案也能追溯。引入最新信息源后,知识更新速度也快,系统能及时吸收领域动态。
7.2.2 搭建一个 RAG 框架
我们直接动手搭一个简化版,叫 Tiny-RAG。它只保留检索和生成两块,方便看清楚 RAG 怎么跑。
第 1 步:RAG 流程介绍
RAG 的思路不复杂,就是在语言模型生成答案前,先从文档库里检索相关信息,再用这些信息引导生成。这样内容更准、更相关,幻觉更少,知识更新更快,生成也能追溯。
它需要哪些部件?
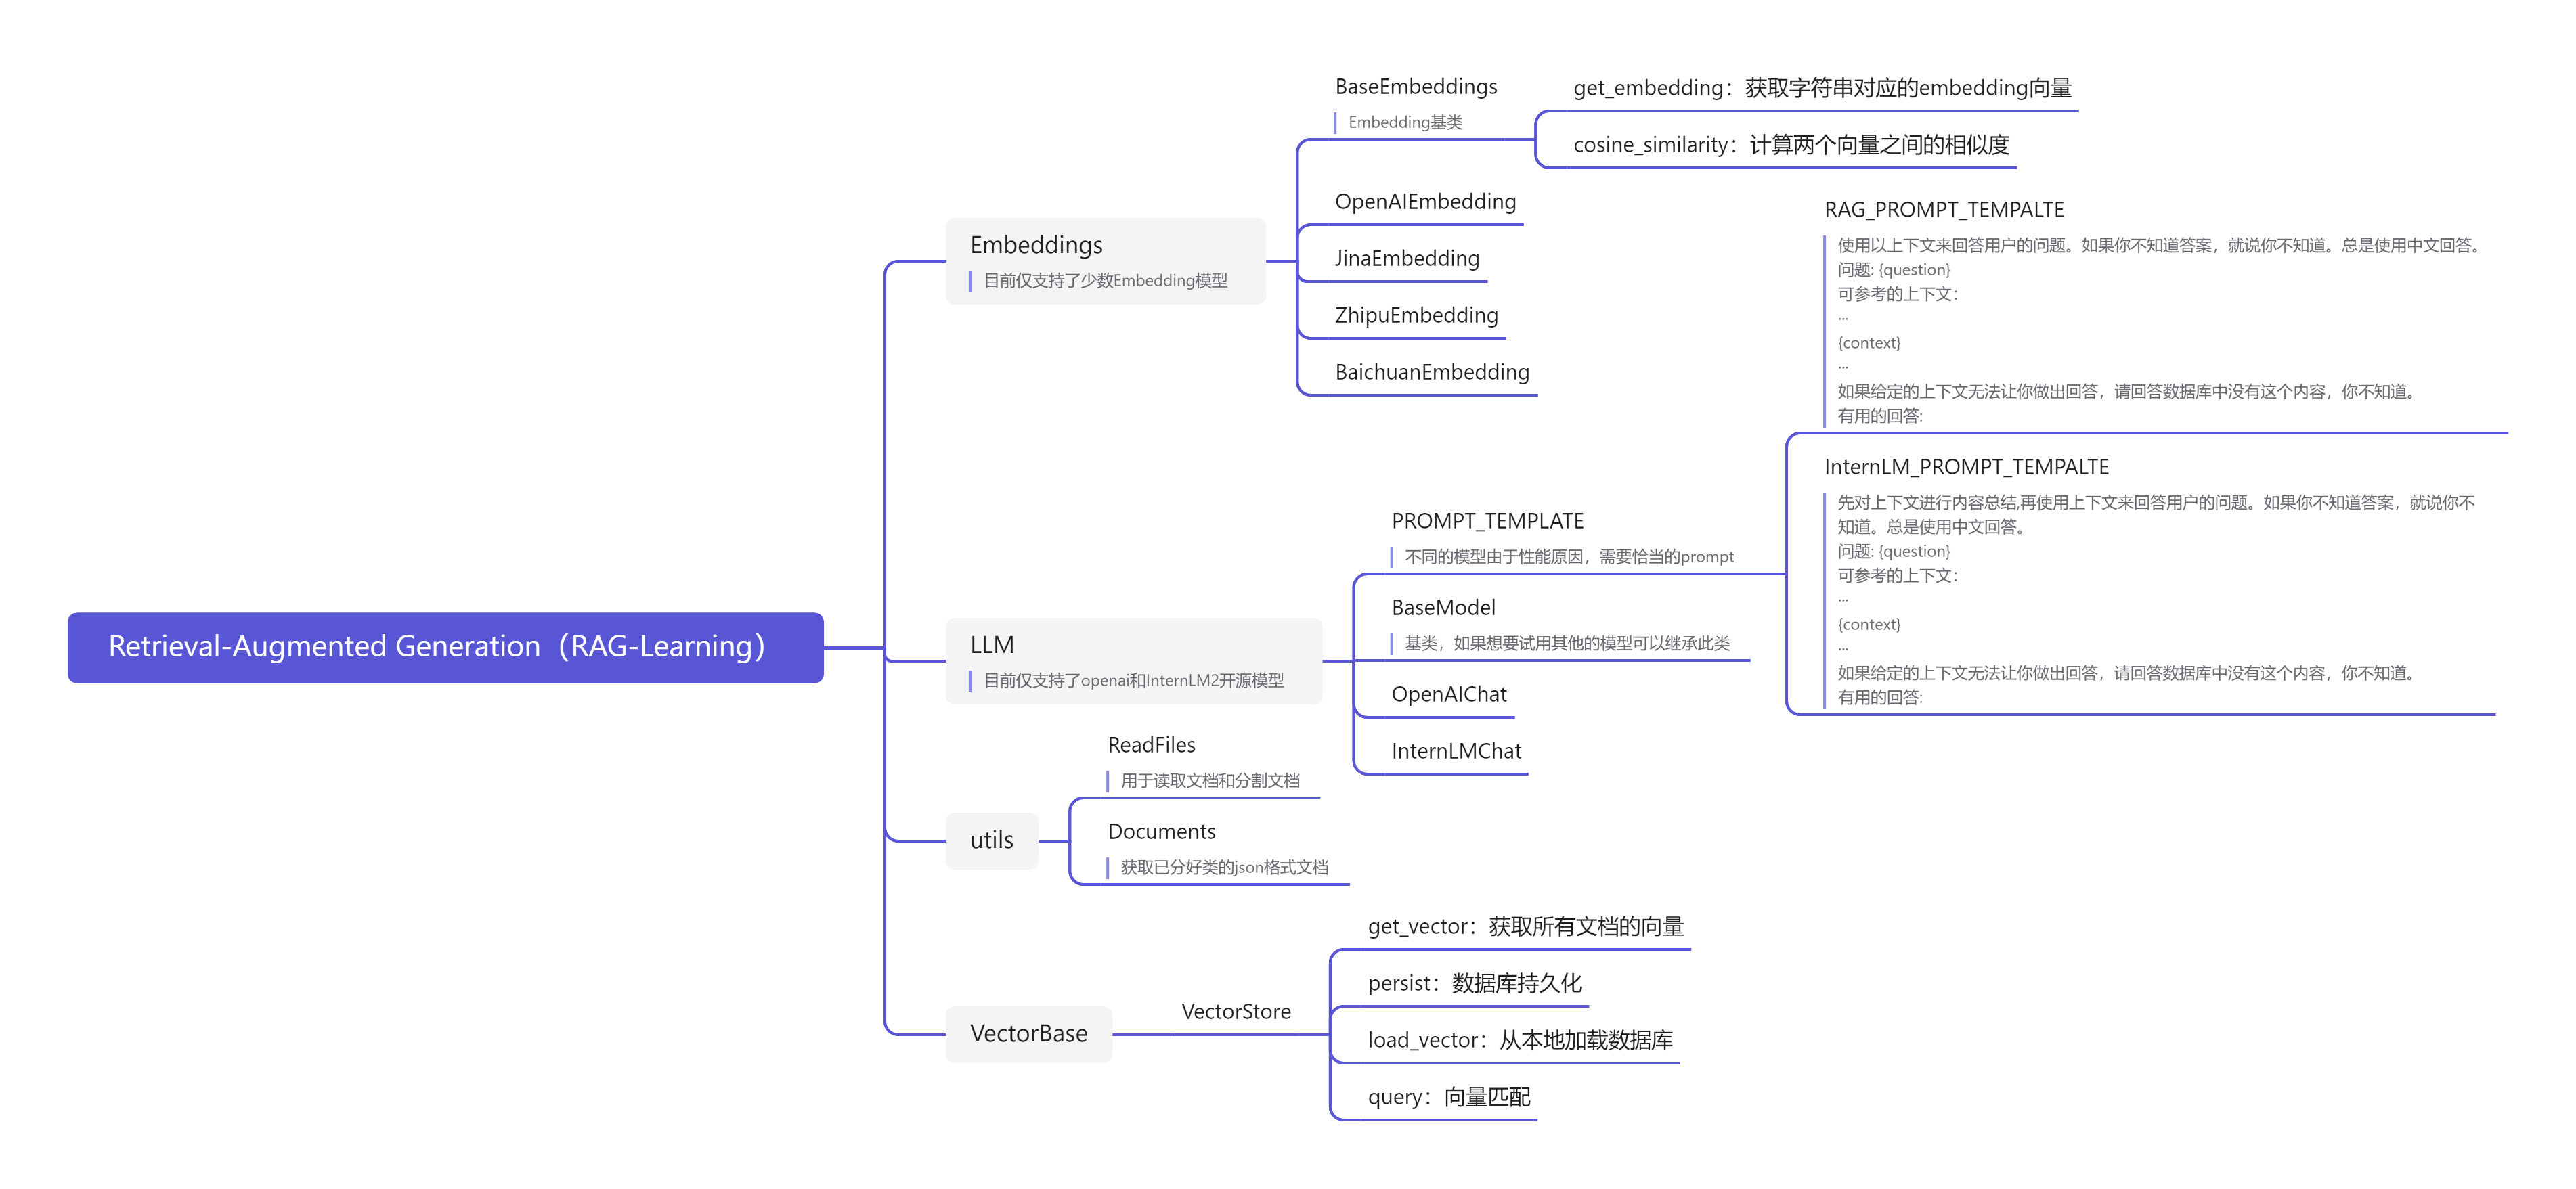
- 向量化模块:把文档片段转成向量。
- 文档加载和切分模块:加载文档,切成片段。
- 数据库:存文档片段和对应向量。
- 检索模块:根据问题找相关文档片段。
- 大模型模块:根据检索到的文档回答用户。
TinyRAG 就这几个模块,图 7.5 是项目结构。
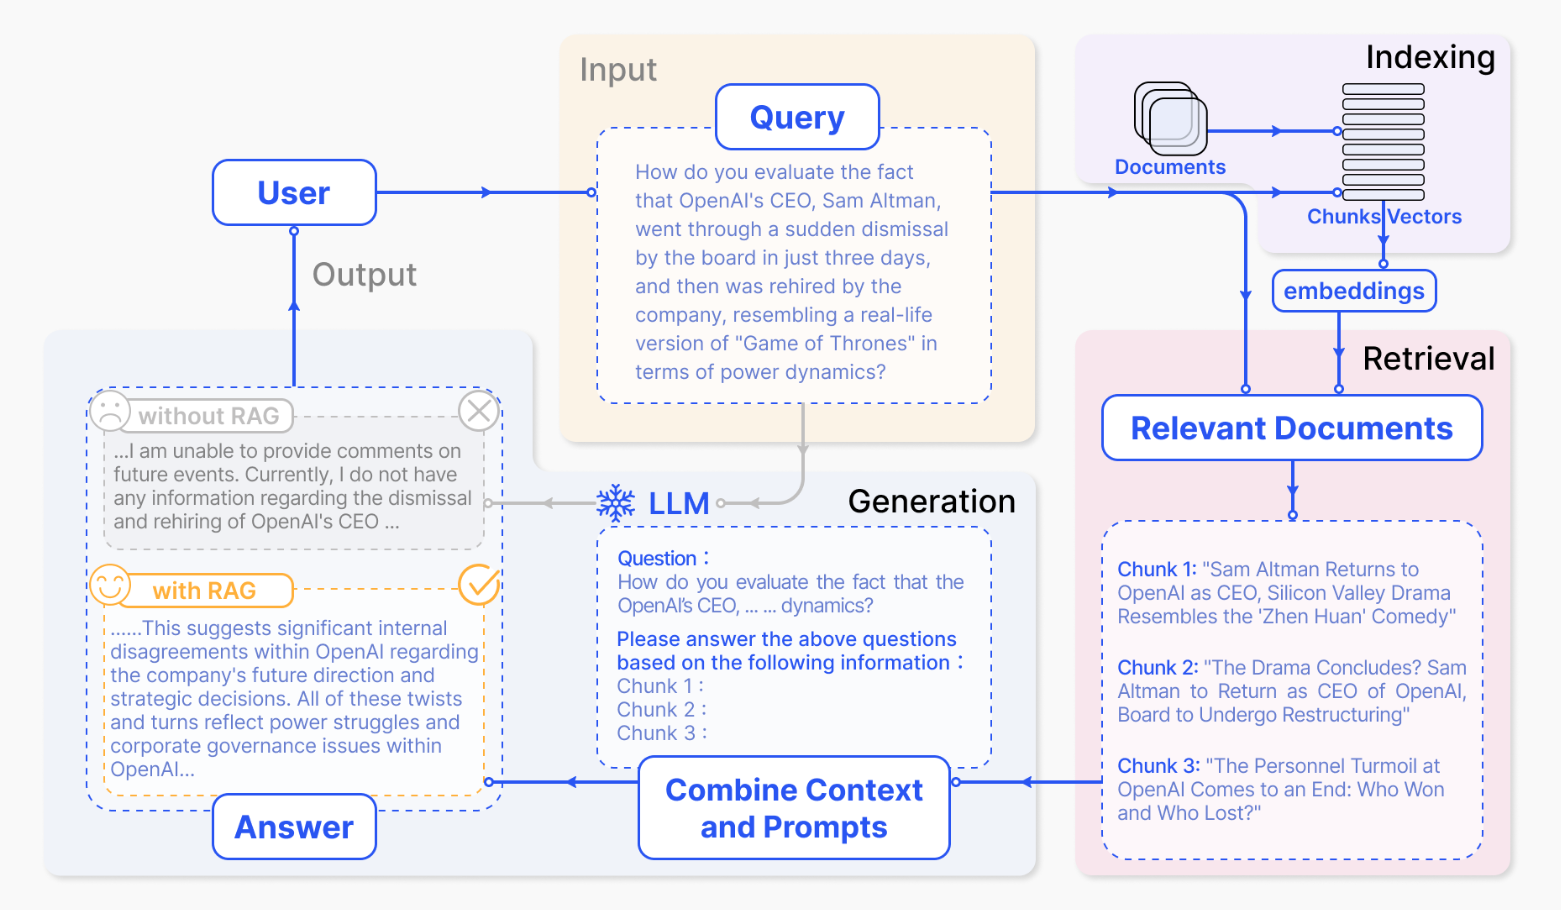
流程分三步。
- 索引:把文档库切成短片段,用编码器建向量索引。
- 检索:根据问题和片段的相似度,找相关文档片段。
- 生成:把检索到的上下文作为条件,生成回答。
图 7.6 是流程图,来源是一篇 RAG 综述论文。
第 2 步:文档加载和切分
先写一个文档加载和切分的类,用来加载文档并切成片段。
文档可以是文章、书籍、对话、代码等文本内容,比如 pdf、md、txt 文件。完整代码在 RAG/utils.py 文件里。下面这段支持加载 pdf、md、txt,扩展名不同,读取方法不同。
def read_file_content(cls, file_path: str):
    # 根据文件扩展名选择读取方法
    if file_path.endswith('.pdf'):
        return cls.read_pdf(file_path)
    elif file_path.endswith('.md'):
        return cls.read_markdown(file_path)
    elif file_path.endswith('.txt'):
        return cls.read_text(file_path)
    else:
        raise ValueError("Unsupported file type")
文档读取后要切分。设一个最大词元长度,按这个长度切。切的时候最好以句子为单位,按换行粗切,片段之间留一点重叠,检索会更准。
def get_chunk(cls, text: str, max_token_len: int = 600, cover_content: int = 150):
    chunk_text = []

    curr_len = 0
    curr_chunk = ''
切分的完整实现如下:
def get_chunk(cls, text: str, max_token_len: int = 600, cover_content: int = 150):
    chunk_text = []

    curr_len = 0
    curr_chunk = ''

    token_len = max_token_len - cover_content
    lines = text.splitlines()  # 假设以换行符分割文本为行

    for line in lines:
        # 保留空格,只移除行首行尾空格
        line = line.strip()
        line_len = len(enc.encode(line))

        if line_len > max_token_len:
            # 如果单行长度就超过限制,则将其分割成多个块
            # 先保存当前块(如果有内容)
            if curr_chunk:
                chunk_text.append(curr_chunk)
                curr_chunk = ''
                curr_len = 0

            # 将长行按token长度分割
            line_tokens = enc.encode(line)
            num_chunks = (len(line_tokens) + token_len - 1) // token_len

            for i in range(num_chunks):
                start_token = i * token_len
                end_token = min(start_token + token_len, len(line_tokens))

                # 解码token片段回文本
                chunk_tokens = line_tokens[start_token:end_token]
                chunk_part = enc.decode(chunk_tokens)

                # 添加覆盖内容(除了第一个块)
                if i > 0 and chunk_text:
                    prev_chunk = chunk_text[-1]
                    cover_part = prev_chunk[-cover_content:] if len(prev_chunk) > cover_content else prev_chunk
                    chunk_part = cover_part + chunk_part

                chunk_text.append(chunk_part)

            # 重置当前块状态
            curr_chunk = ''
            curr_len = 0

        elif curr_len + line_len + 1 <= token_len:  # +1 for newline
            # 当前行可以加入当前块
            if curr_chunk:
                curr_chunk += '\n'
                curr_len += 1
            curr_chunk += line
            curr_len += line_len
        else:
            # 当前行无法加入当前块,开始新块
            if curr_chunk:
                chunk_text.append(curr_chunk)

            # 开始新块,添加覆盖内容
            if chunk_text:
                prev_chunk = chunk_text[-1]
                cover_part = prev_chunk[-cover_content:] if len(prev_chunk) > cover_content else prev_chunk
                curr_chunk = cover_part + '\n' + line
                curr_len = len(enc.encode(cover_part)) + 1 + line_len
            else:
                curr_chunk = line
                curr_len = line_len

    # 添加最后一个块(如果有内容)
    if curr_chunk:
        chunk_text.append(curr_chunk)

    return chunk_text
cover_content 这个参数单独说一下。它管的是相邻块之间的重叠量,默认 150 个 token。代码会把上一块的结尾复制一份,粘到下一块的开头。关键信息就算正好压在切分点上,也能保住。
向量化是 RAG 的地基。一条文本进去,一串数字出来,就是这么回事。
检索能不能找对东西,基本看这一步产出的向量好不好用。
先搭一个 BaseEmbeddings 基类。以后换别的嵌入模型,继承它、改几个方法就行,上层代码不用动。
class BaseEmbeddings:
    """
    Base class for embeddings
    """
    def __init__(self, path: str, is_api: bool) -> None:
        """
        初始化嵌入基类
        Args:
            path (str): 模型或数据的路径
            is_api (bool): 是否使用API方式。True表示使用在线API服务,False表示使用本地模型
        """
        self.path = path
        self.is_api = is_api

    def get_embedding(self, text: str, model: str) -> List[float]:
        """
        获取文本的嵌入向量表示
        Args:
            text (str): 输入文本
            model (str): 使用的模型名称
        Returns:
            List[float]: 文本的嵌入向量
        Raises:
            NotImplementedError: 该方法需要在子类中实现
        """
        raise NotImplementedError

    @classmethod
    def cosine_similarity(cls, vector1: List[float], vector2: List[float]) -> float:
        """
        计算两个向量之间的余弦相似度
        Args:
            vector1 (List[float]): 第一个向量
            vector2 (List[float]): 第二个向量
        Returns:
            float: 两个向量的余弦相似度,范围在[-1,1]之间
        """
        # 将输入列表转换为numpy数组,并指定数据类型为float32
        v1 = np.array(vector1, dtype=np.float32)
        v2 = np.array(vector2, dtype=np.float32)

        # 检查向量中是否包含无穷大或NaN值
        if not np.all(np.isfinite(v1)) or not np.all(np.isfinite(v2)):
            return 0.0
文档切好之后,下一步是把每个片段转成向量。先定义嵌入基类,把公共逻辑放在这里。
class BaseEmbeddings:
    """
    Base class for embeddings
    """
    def __init__(self, path: str, is_api: bool) -> None:
        """
        初始化嵌入基类
        Args:
            path (str): 模型或数据的路径
            is_api (bool): 是否使用API方式。True表示使用在线API服务,False表示使用本地模型
        """
        self.path = path
        self.is_api = is_api

    def get_embedding(self, text: str, model: str) -> List[float]:
        """
        获取文本的嵌入向量表示
        Args:
            text (str): 输入文本
            model (str): 使用的模型名称
        Returns:
            List[float]: 文本的嵌入向量
        Raises:
            NotImplementedError: 该方法需要在子类中实现
        """
        raise NotImplementedError

    @classmethod
    def cosine_similarity(cls, vector1: List[float], vector2: List[float]) -> float:
        """
        计算两个向量之间的余弦相似度
        Args:
            vector1 (List[float]): 第一个向量
            vector2 (List[float]): 第二个向量
        Returns:
            float: 两个向量的余弦相似度,范围在[-1,1]之间
        """
        # 将输入列表转换为numpy数组,并指定数据类型为float32
        v1 = np.array(vector1, dtype=np.float32)
        v2 = np.array(vector2, dtype=np.float32)

        # 检查向量中是否包含无穷大或NaN值
        if not np.all(np.isfinite(v1)) or not np.all(np.isfinite(v2)):
            return 0.0

        # 计算向量的点积
        dot_product = np.dot(v1, v2)
        # 计算向量的范数(长度)
        norm_v1 = np.linalg.norm(v1)
        norm_v2 = np.linalg.norm(v2)

        # 计算分母(两个向量范数的乘积)
        magnitude = norm_v1 * norm_v2
        # 处理分母为0的特殊情况
        if magnitude == 0:
            return 0.0

        # 返回余弦相似度
        return dot_product / magnitude
BaseEmbeddings 里有两个主要方法。get_embedding 负责把文本转成向量,cosine_similarity 负责算两个向量的余弦相似度。初始化时记下模型路径和是否走 API,比如用 OpenAI 的 Embedding 接口,就把 self.is_api 设成 True。子类继承时只需要实现 get_embedding,相似度计算直接复用。写基类就是省这个事。
class OpenAIEmbedding(BaseEmbeddings):
    """
    class for OpenAI embeddings
    """
    def __init__(self, path: str = '', is_api: bool = True) -> None:
        super().__init__(path, is_api)
        if self.is_api:
            self.client = OpenAI()
            # 从环境变量中获取 硅基流动 密钥
            self.client.api_key = os.getenv("OPENAI_API_KEY")
            # 从环境变量中获取 硅基流动 的基础URL
            self.client.base_url = os.getenv("OPENAI_BASE_URL")

    def get_embedding(self, text: str, model: str = "BAAI/bge-m3") -> List[float]:
        """
        此处默认使用硅基流动的免费嵌入模型 BAAI/bge-m3
        """
        if self.is_api:
            text = text.replace("\n", " ")
            return self.client.embeddings.create(input=[text], model=model).data[0].embedding
        else:
            raise NotImplementedError
OpenAIEmbedding 用的是 OpenAI 兼容接口。初始化时创建 client,从环境变量读 OPENAI_API_KEY 和 OPENAI_BASE_URL。默认模型写成 BAAI/bge-m3。get_embedding 先把换行替换成空格,再调用 embeddings.create,取第一条结果的 embedding。如果 is_api 是 False,这里没实现本地推理,直接抛 NotImplementedError。
注:这里默认用硅基流动的大模型 API 平台,国内访问方便:硅基流动大模型API服务平台。
文档切分和嵌入模型都好了以后,需要放文档片段和对应向量。向量数据库大概做四件事:持久化保存、从本地加载、获取文档向量、根据问题检索。VectorStore 先把这几个接口留出来。
完整代码在 VectorBase.py 里。
class VectorStore:
    def __init__(self, document: List[str] = ['']) -> None:
        self.document = document

    def get_vector(self, EmbeddingModel: BaseEmbeddings) -> List[List[float]]:
        # 获得文档的向量表示
        pass

    def persist(self, path: str = 'storage'):
        # 数据库持久化保存
        pass

    def load_vector(self, path: str = 'storage'):
        # 从本地加载数据库
        pass

    def query(self, query: str, EmbeddingModel: BaseEmbeddings, k: int = 1) -> List[str]:
        # 根据问题检索相关文档片段
        pass
query 是检索入口。把用户问题向量化,再和库里每个向量算相似度,最后返回最相关的 k 个文档片段。实现很短:
def query(self, query: str, EmbeddingModel: BaseEmbeddings, k: int = 1) -> List[str]:
    query_vector = EmbeddingModel.get_embedding(query)
    result = np.array([self.get_similarity(query_vector, vector) for vector in self.vectors])
    return np.array(self.document)[result.argsort()[-k:][::-1]].tolist()
这里用 np.array 存相似度,argsort 得到升序索引,取最后 k 个再倒序,就是分数最高的几个。get_similarity 在类里实现,实际就是调 cosine_similarity。
第五步:大模型模块
大模型模块负责根据检索到的文档回答用户问题。先写一个基类,后面换别的模型也方便。
class BaseModel:
    def __init__(self, path: str = '') -> None:
        self.path = path

    def chat(self, prompt: str, history: List[dict], content: str) -> str:
        pass
模型这边也抽象一个基类。
class BaseModel:
    def __init__(self, path: str = '') -> None:
        self.path = path

    def chat(self, prompt: str, history: List[dict], content: str) -> str:
        pass

    def load_model(self):
        pass
BaseModel 里留了两个方法:chat 和 load_model。本地跑开源模型,load_model 得自己实现;走 API 的模型不用管它。这里继续用硅基流动,国内访问方便,用户不用准备本地显卡,学习门槛低不少。
from openai import OpenAI

class OpenAIChat(BaseModel):
    def __init__(self, model: str = "Qwen/Qwen2.5-32B-Instruct") -> None:
        self.model = model

    def chat(self, prompt: str, history: List[dict], content: str) -> str:
        client = OpenAI()
        client.api_key = os.getenv("OPENAI_API_KEY")
        client.base_url = os.getenv("OPENAI_BASE_URL")
        history.append({'role': 'user', 'content': RAG_PROMPT_TEMPLATE.format(question=prompt, context=content)})
        response = client.chat.completions.create(
            model=self.model,
            messages=history,
            max_tokens=2048,
            temperature=0.1
        )
        return response.choices[0].message.content
给 RAG 专门写一个提示词模板,把问题和检索到的内容塞进去:
RAG_PROMPT_TEMPLATE = """
使用以下上下文来回答用户的问题。如果你不知道答案,就说你不知道。总是使用中文回答。
问题: {question}
可参考的上下文:
···
{context}
···
如果给定的上下文无法让你做出回答,请回答数据库中没有这个内容,你不知道。
有用的回答:
"""
到这一步,大模型这块就接上了。
第 6 步:Tiny-RAG 演示
Tiny-RAG 的演示长这样:
from VectorBase import VectorStore
from utils import ReadFiles
from LLM import OpenAIChat
from Embeddings import OpenAIEmbedding


docs = ReadFiles('./data').get_content(max_token_len=600, cover_content=150) # 获得 data 目录下的所有文件内容并分割
vector = VectorStore(docs)
embedding = OpenAIEmbedding() # 创建 EmbeddingModel
vector.get_vector(EmbeddingModel=embedding)
vector.persist(path='storage') # 将向量和文档内容保存到 storage 目录下,下次再用就可以直接加载本地的数据库

# vector.load_vector('./storage') # 加载本地的数据库

question = 'RAG的原理是什么?'

content = vector.query(question, EmbeddingModel=embedding, k=1)[0]
chat = OpenAIChat(model='Qwen/Qwen2.5-32B-Instruct')
print(chat.chat(question, [], content))
数据库已经存过的话,不用每次重新切文档、算向量:
from VectorBase import VectorStore
from utils import ReadFiles
from LLM import OpenAIChat
from Embeddings import OpenAIEmbedding

# 保存数据库之后
vector = VectorStore()

vector.load_vector('./storage') # 加载本地的数据库

question = 'RAG的原理是什么?'

embedding = OpenAIEmbedding() # 创建 EmbeddingModel

content = vector.query(question, EmbeddingModel=embedding, k=1)[0]
chat = OpenAIChat(model='Qwen/Qwen2.5-32B-Instruct')
print(chat.chat(question, [], content))
content = vector.query(question, EmbeddingModel=embedding, k=1)[0]
chat = OpenAIChat(model='Qwen/Qwen2.5-32B-Instruct')
print(chat.chat(question, [], content))
注:7.2 节涉及的所有代码都放在 Happy-LLM Chapter7 RAG 里。
7.3 智能体
7.3.1 什么是 LLM 智能体?
简单说,大模型智能体把 LLM 当成“大脑”,再给它配上自主规划、记忆和工具调用能力。用户给一个提示,它不只是回一段话。它可以:
- 理解目标:接住一个复杂或高层目标,比如“帮我规划周末去北京,订机票和酒店”。
- 自主规划:把大目标拆成可执行步骤,比如搜景点、查天气、比机票、找酒店、调预订接口。
- 记忆:短期记住当前任务上下文,长期能从过去交互或外部知识库检索信息。
- 工具使用:调用外部 API、插件或代码环境获取信息,执行操作,做计算。
- 反思与迭代:高级智能体会评估自己的行为和结果,据此调整后续计划。
传统 LLM 像知识渊博但只能纸上谈兵的图书馆员。LLM 智能体更像能跑腿的私人助理,懂很多,也能把事办了,甚至主动想更优方案。
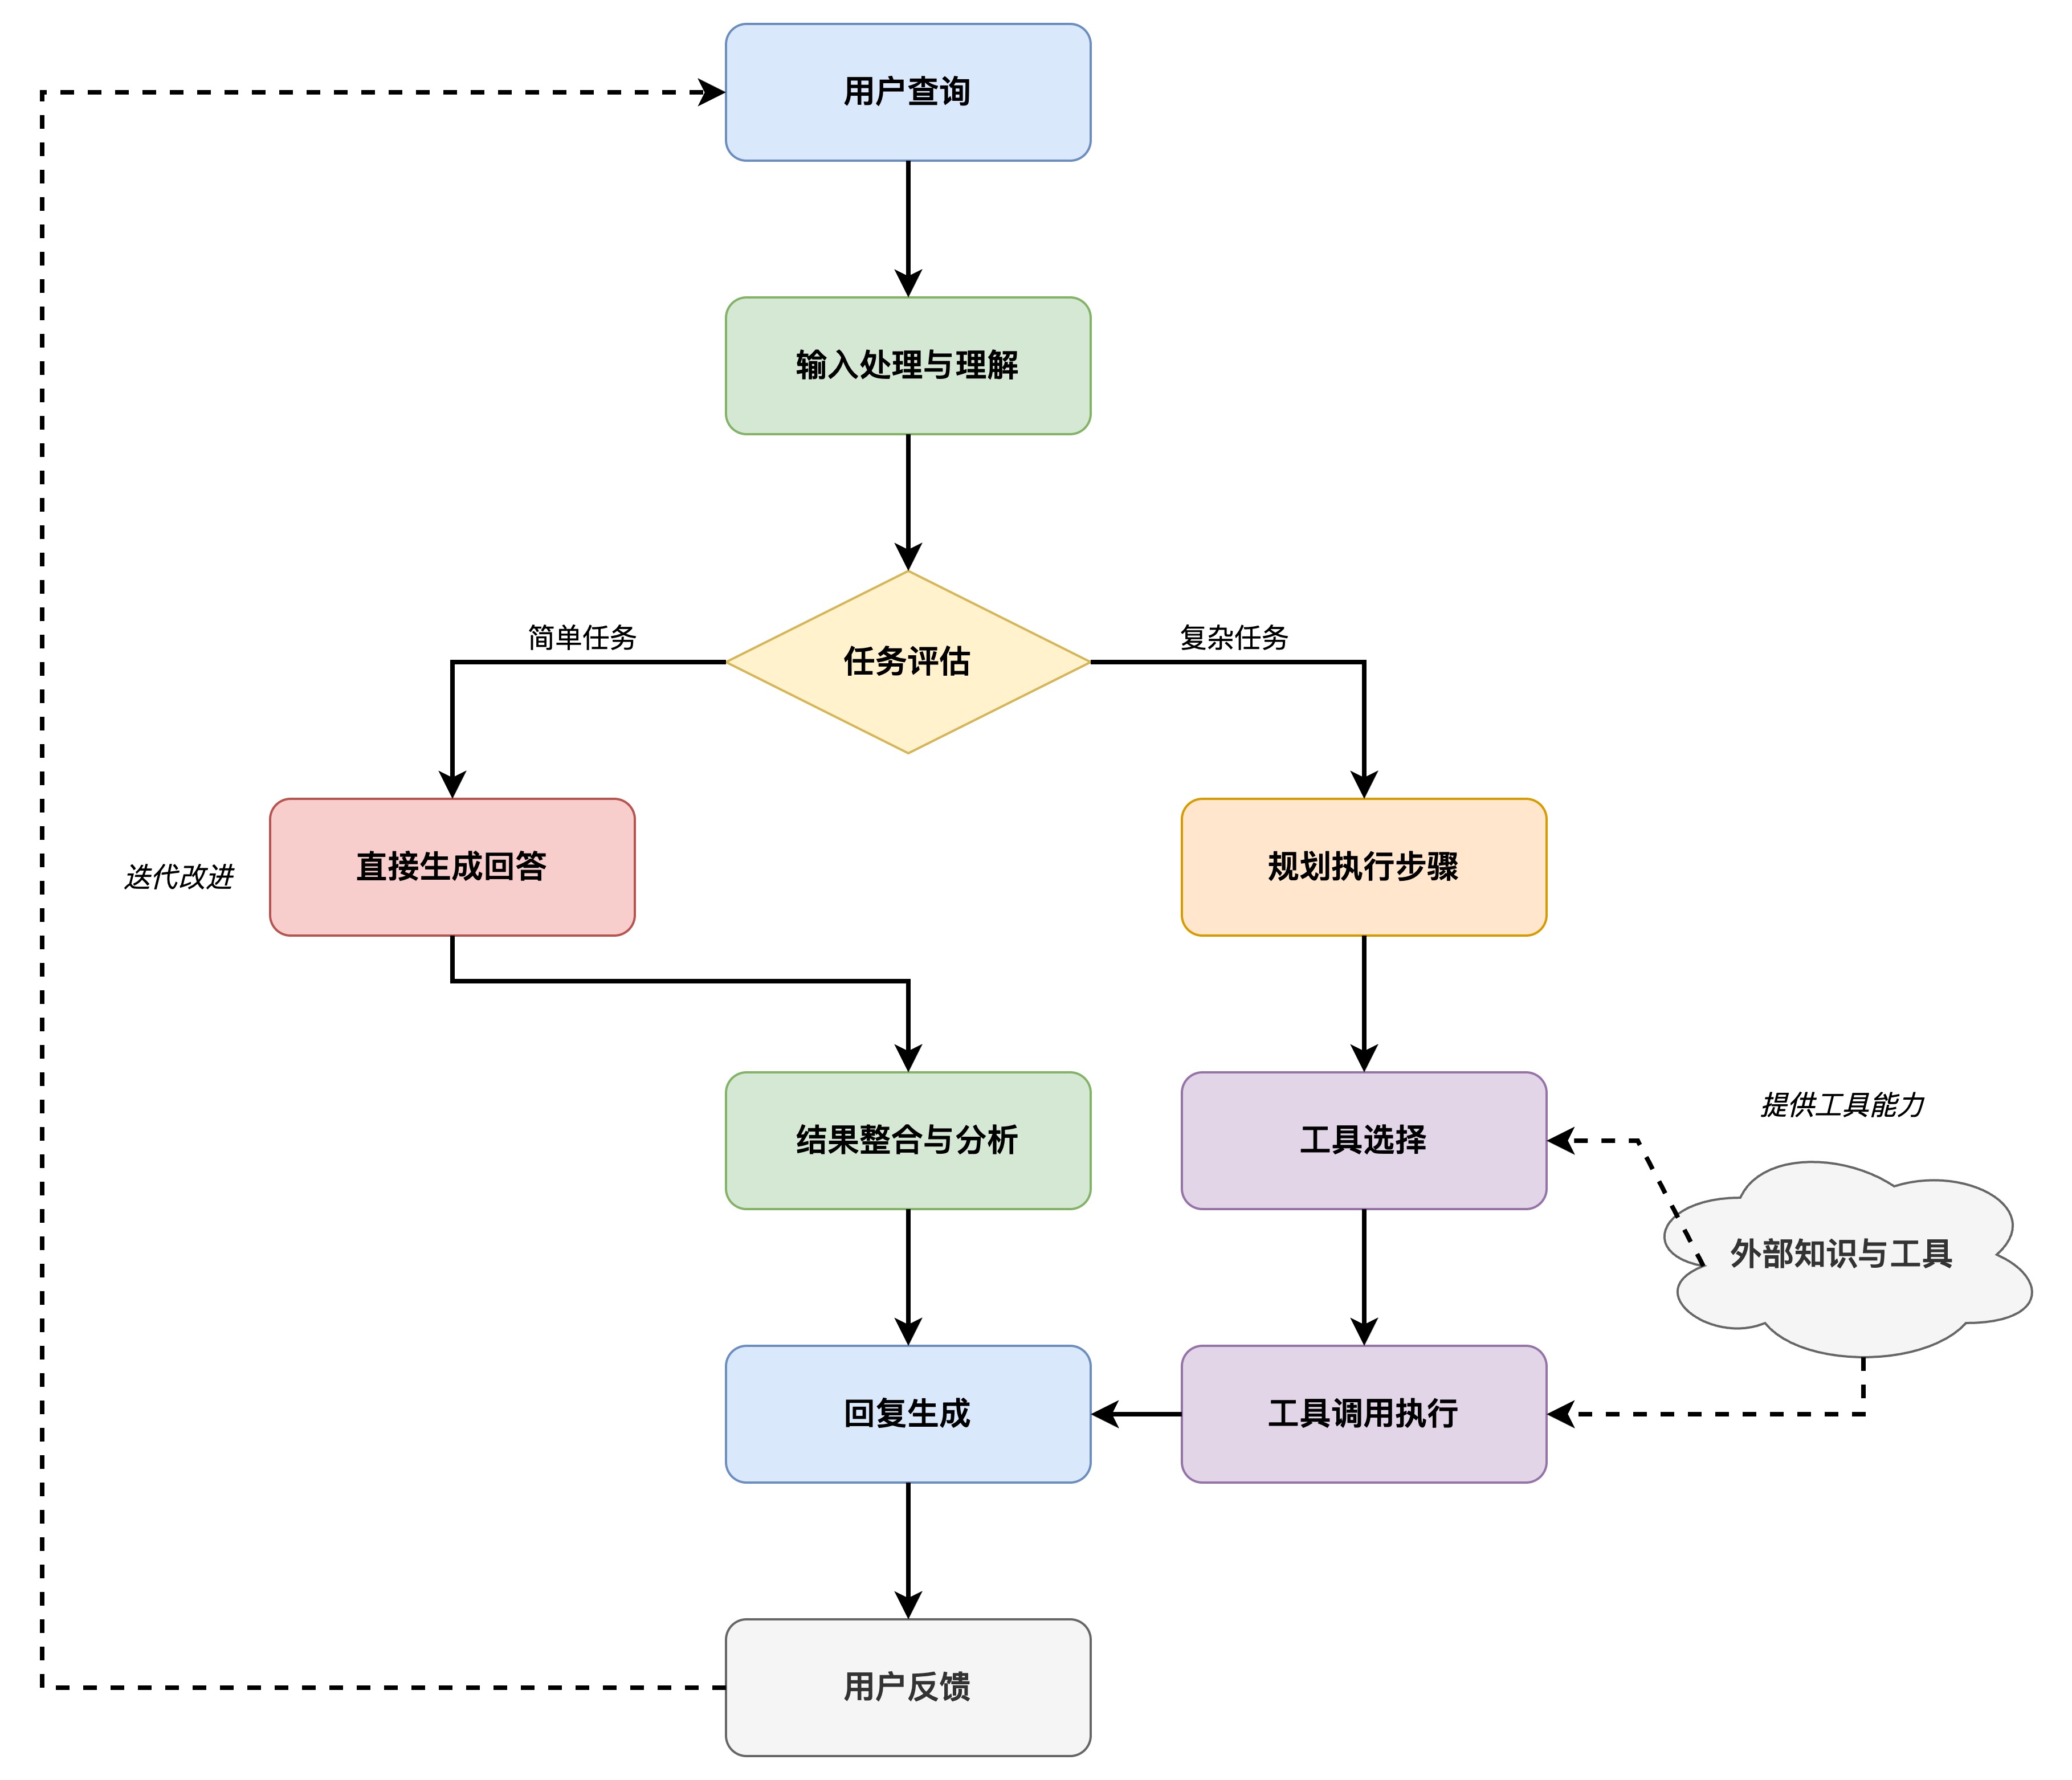
图7.7 智能体工作原理
LLM 智能体把语言理解、生成能力和规划、记忆、工具使用等模块拼在一起,因而能处理更复杂的任务。法律、医疗、金融这些垂直领域都有它的用武之地,图7.7 展示了它的工作方式。
7.3.2 LLM 智能体的类型
LLM 智能体的概念还在快速变化。按设计理念和能力侧重,大致能分几类。
任务导向型智能体:
- 特点:盯住特定领域、定义明确的任务,比如客服、代码生成、数据分析。
- 工作方式:一般有预设流程和特定工具集。LLM 负责理解用户意图、填充任务槽位、生成回应或调用合适工具。
- 例子:专门订餐厅的聊天机器人、辅助编程的代码助手。GitHub Copilot 的一些高级功能就带智能体特性。
规划与推理型智能体:
- 特点:强调自主拆复杂任务、制定多步计划,并根据环境反馈调整。对推理能力要求更高。
- 工作方式:常见框架是 ReAct(Reason+Act)。模型先“思考”当前情况和要做什么,再执行“行动”调用工具,然后根据工具返回结果进入下一轮。Chain-of-Thought(CoT)这类提示工程也是推理基础。
- 例子:整合网络搜索、计算器、数据库查询来回答复杂问题的研究型智能体;或者自主完成“写一篇某主题报告,配相关数据图表”的智能体。
多智能体系统:
- 特点:多个角色或能力不同的智能体协同,完成更大的目标。
- 工作方式:智能体之间能通信、协作、辩论,甚至竞争。一个负责规划,一个负责执行,一个负责审查。
- 例子:模拟软件开发团队自动生成和测试代码;模拟公司组织结构完成商业策划。AutoGen、ChatDev 等框架支持这类系统。
探索与学习型智能体:
- 特点:不只执行任务,还能在与环境交互中主动学新知识、新技能,或优化自身策略,类似强化学习里的智能体。
- 工作方式:可能有更复杂的记忆和反思机制,根据成功或失败经验调整未来规划和行动。
- 例子:在未知软件环境里自主探索怎么操作的智能体;玩游戏时不断提升策略的智能体。
7.3.3 动手构造一个 Tiny-Agent
这里基于 openai 库和 tool_calls 功能,做一个 Tiny-Agent。它属于简单的任务导向型智能体,能根据用户输入回答一些简单问题。最终效果见图7.8。
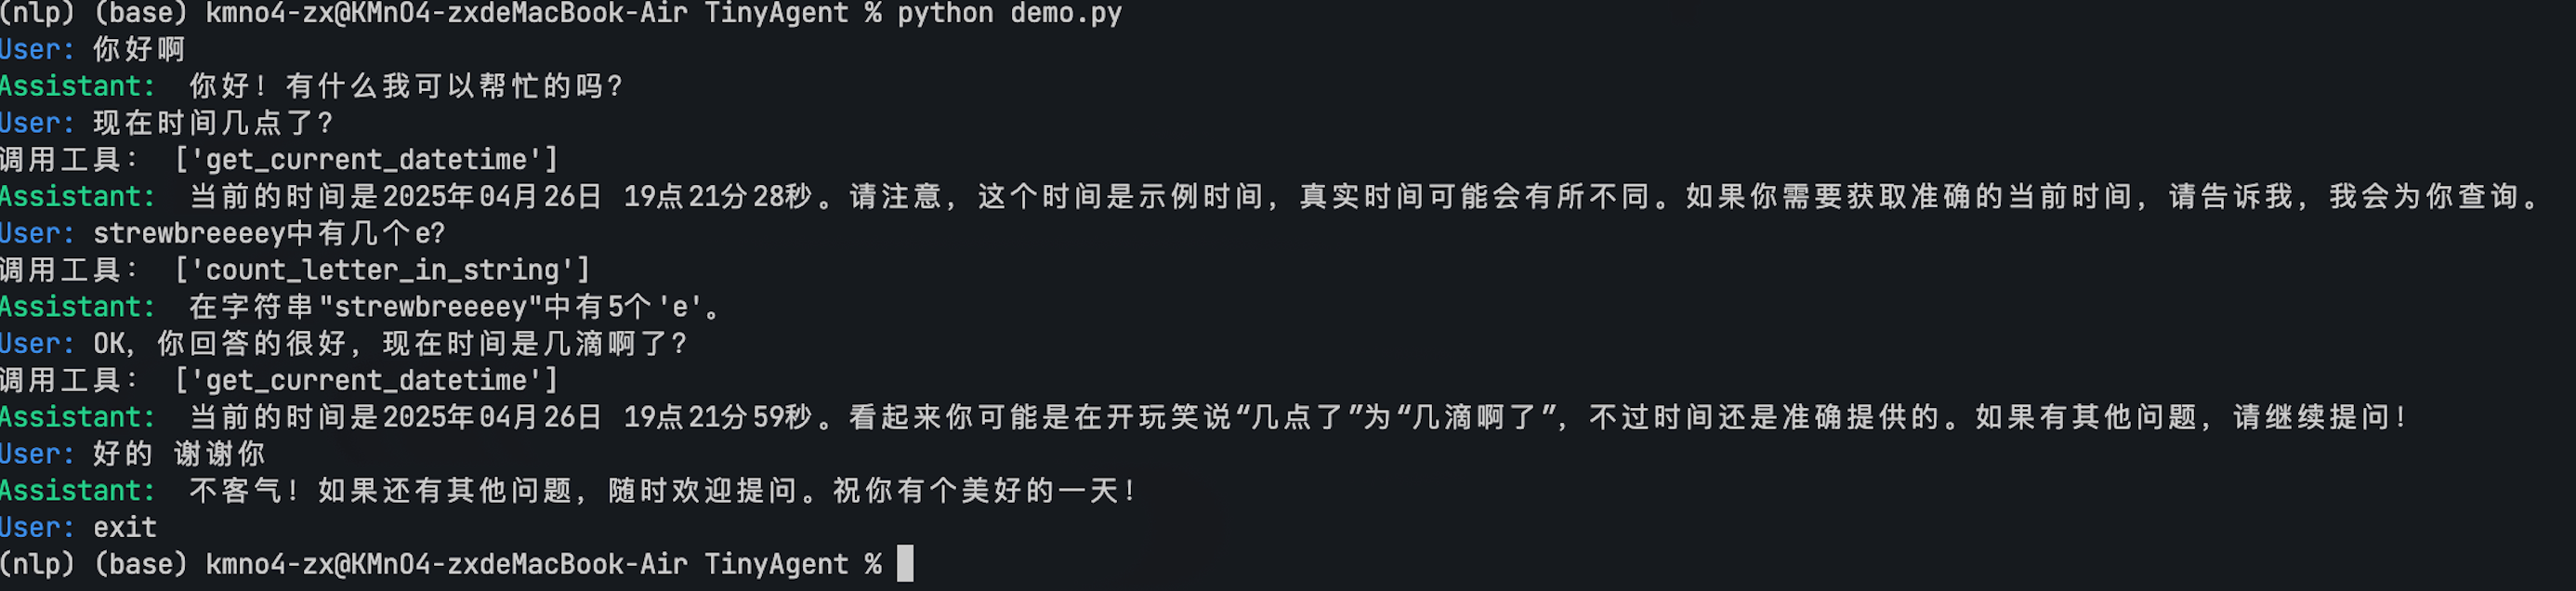
图7.8 效果示意图
第 1 步:初始化客户端和模型
先准备一个能调用大模型的客户端。使用 openai 库,把地址指到一个兼容 OpenAI API 的服务,比如 SiliconFlow。模型指定为 Qwen/Qwen2.5-32B-Instruct。
from openai import OpenAI

# 初始化 OpenAI 客户端
client = OpenAI(
    api_key="YOUR_API_KEY",  # 替换为你的 API Key
    base_url="https://api.siliconflow.cn/v1", # 使用 SiliconFlow 的 API 地址
)

# 指定模型名称
model_name = "Qwen/Qwen2.5-32B-Instruct"
注意:把
YOUR_API_KEY换成从 SiliconFlow 或其他服务商拿到的有效 API Key。
第 2 步:定义工具函数
在 src/tools.py 里定义智能体可用的工具函数。每个函数都要有清晰的文档字符串,说明功能和参数。后面生成工具 JSON Schema 时会用到。
# src/tools.py
from datetime import datetime

# 获取当前日期和时间
def get_current_datetime() -> str:
    """
    获取当前日期和时间。
    :return: 当前日期和时间的字符串表示。
    """
    current_datetime = datetime.now()
    formatted_datetime = current_datetime.strftime("%Y-%m-%d %H:%M:%S")
    return formatted_datetime

def count_letter_in_string(a: str, b: str):
    """
    统计字符串中某个字母的出现次数。
    :param a: 要搜索的字符串。
    :param b: 要统计的字母。
    :return: 字母在字符串中出现的次数。
    """
    return str(a.count(b))

def search_wikipedia(query: str) -> str:
    """
    在维基百科中搜索指定查询的前三个页面摘要。
    :param query: 要搜索的查询字符串。
    :return: 包含前三个页面摘要的字符串。
    """
    page_titles = wikipedia.search(query)
    summaries = []
    for page_title in page_titles[: 3]:  # 取前三个页面标题
        try:
            # 使用 wikipedia 模块的 page 函数,获取指定标题的维基百科页面对象。
            wiki_page = wikipedia.page(title=page_title, auto_suggest=False)
            # 获取页面摘要
            summaries.append(f"页面: {page_title}\n摘要: {wiki_page.summary}")
        except (
                wikipedia.exceptions.PageError,
                wikipedia.exceptions.DisambiguationError,
        ):
            pass
    if not summaries:
        return "维基百科没有搜索到合适的结果"
    return "\n\n".join(summaries)
# ... (可能还有其他工具函数)
OpenAI API 要理解这些工具,需要把它们转成特定的 JSON Schema 格式。src/utils.py 里的 function_to_json 辅助函数负责这件事。
# src/utils.py (部分)
import inspect

def function_to_json(func) -> dict:
    # ... (函数实现细节)
    # 返回符合 OpenAI tool schema 的字典
    return {
        "type": "function",
        "function": {
            "name": func.__name__,
            "description": inspect.getdoc(func),
            "parameters": {
                "type": "object",
                "properties": parameters,
                "required": required,
            },
        },
    }
这一步的前半段我们已经把工具函数和 function_to_json 准备好了,接下来把它们交给一个 Agent 来管。
Step 3: 构造 Agent 类
我们在 src/core.py 文件中定义 Agent 类。这个类负责管理对话历史、调用 OpenAI API、处理工具调用请求以及执行工具函数。
# src/core.py (部分)
from openai import OpenAI
import json
from typing import List, Dict, Any
from utils import function_to_json
# 导入定义好的工具函数
from tools import get_current_datetime, add, compare, count_letter_in_string

SYSTEM_PROMPT = """
你是一个叫不要葱姜蒜的人工智能助手。你的输出应该与用户的语言保持一致。
当用户的问题需要调用工具时,你可以从提供的工具列表中调用适当的工具函数。
"""

class Agent:
    def __init__(self, client: OpenAI, model: str = "Qwen/Qwen2.5-32B-Instruct", tools: List=[], verbose : bool = True):
        self.client = client
        self.tools = tools
        self.model = model
        self.messages = [
            {"role": "system", "content": SYSREM_PROMPT},
        ]
        self.verbose = verbose

    def get_tool_schema(self) -> List[Dict[str, Any]]:
        # 获取所有工具的 JSON 模式
        return [function_to_json(tool) for tool in self.tools]

    def handle_tool_call(self, tool_call):
        # 处理工具调用
        function_name = tool_call.function.name
        function_args = tool_call.function.arguments
        function_id = tool_call.id

        function_call_content = eval(f"{function_name}(**{function_args})")

        return {
            "role": "tool",
            "content": function_call_content,
            "tool_call_id": function_id,
        }

    def get_completion(self, prompt) -> str:

        self.messages.append({"role": "user", "content": prompt})

        # 获取模型的完成响应
        response = self.client.chat.completions.create(
            model=self.model,
            messages=self.messages,
            tools=self.get_tool_schema(),
            stream=False,
        )

        # 检查模型是否调用了工具
        if response.choices[0].message.tool_calls:
            self.messages.append({"role": "assistant", "content": response.choices[0].message.content})
            # 处理工具调用
            tool_list = []
            for tool_call in response.choices[0].message.tool_calls:
                # 处理工具调用并将结果添加到消息列表中
                self.messages.append(self.handle_tool_call(tool_call))
                tool_list.append([tool_call.function.name, tool_call.function.arguments])
            if self.verbose:
                print("调用工具:", response.choices[0].message.content, tool_list)
            # 再次获取模型的完成响应,这次包含工具调用的结果
            response = self.client.chat.completions.create(
                model=self.model,
                messages=self.messages,
                tools=self.get_tool_schema(),
                stream=False,
            )

        # 将模型的完成响应添加到消息列表中
        self.messages.append({"role": "assistant", "content": response.choices[0].message.content})
        return response.choices[0].message.content
构造函数接收 client、model 和 tools,verbose 打开后终端里能看到每次的工具调用信息。messages 一开始只有一条 system 消息,之后用户输入、模型回复、工具返回的结果,全部按顺序往这个列表里追加,每次请求都把整个列表发出去。
get_tool_schema 把工具列表里的每个函数转成 JSON schema,转换逻辑就是上一节写好的 function_to_json。
handle_tool_call 负责真正执行工具。它从 tool_call 里取出函数名、参数和 id,拼成一次 Python 调用,再返回一条 role 为 tool 的消息。这里的 tool_call_id 必须和请求里的 id 对上,一次对话里模型可能同时调好几个工具,它就靠这个字段来区分谁是谁。
get_completion 是主流程。先把用户输入追加进 messages,发一次请求。模型这次不打算调工具的话,tool_calls 是空的,直接返回内容就完事。
一旦 tool_calls 有值,说明模型想动手了。这时先把这条带 tool_calls 的 assistant 消息存进历史,然后逐个处理每个工具调用,把执行结果也追加进去。消息列表补齐之后再发第二次请求,这次模型能看到工具返回的结果,用它组织最终回复。最终回复同样存进 messages,然后返回给调用方。
还有一个地方要留意,这段代码只处理了一轮工具调用。模型拿到结果之后如果还想再调一次,流程不会继续往下走。真要做多轮循环,把第二次请求那段包进 while 里判断一下就行。
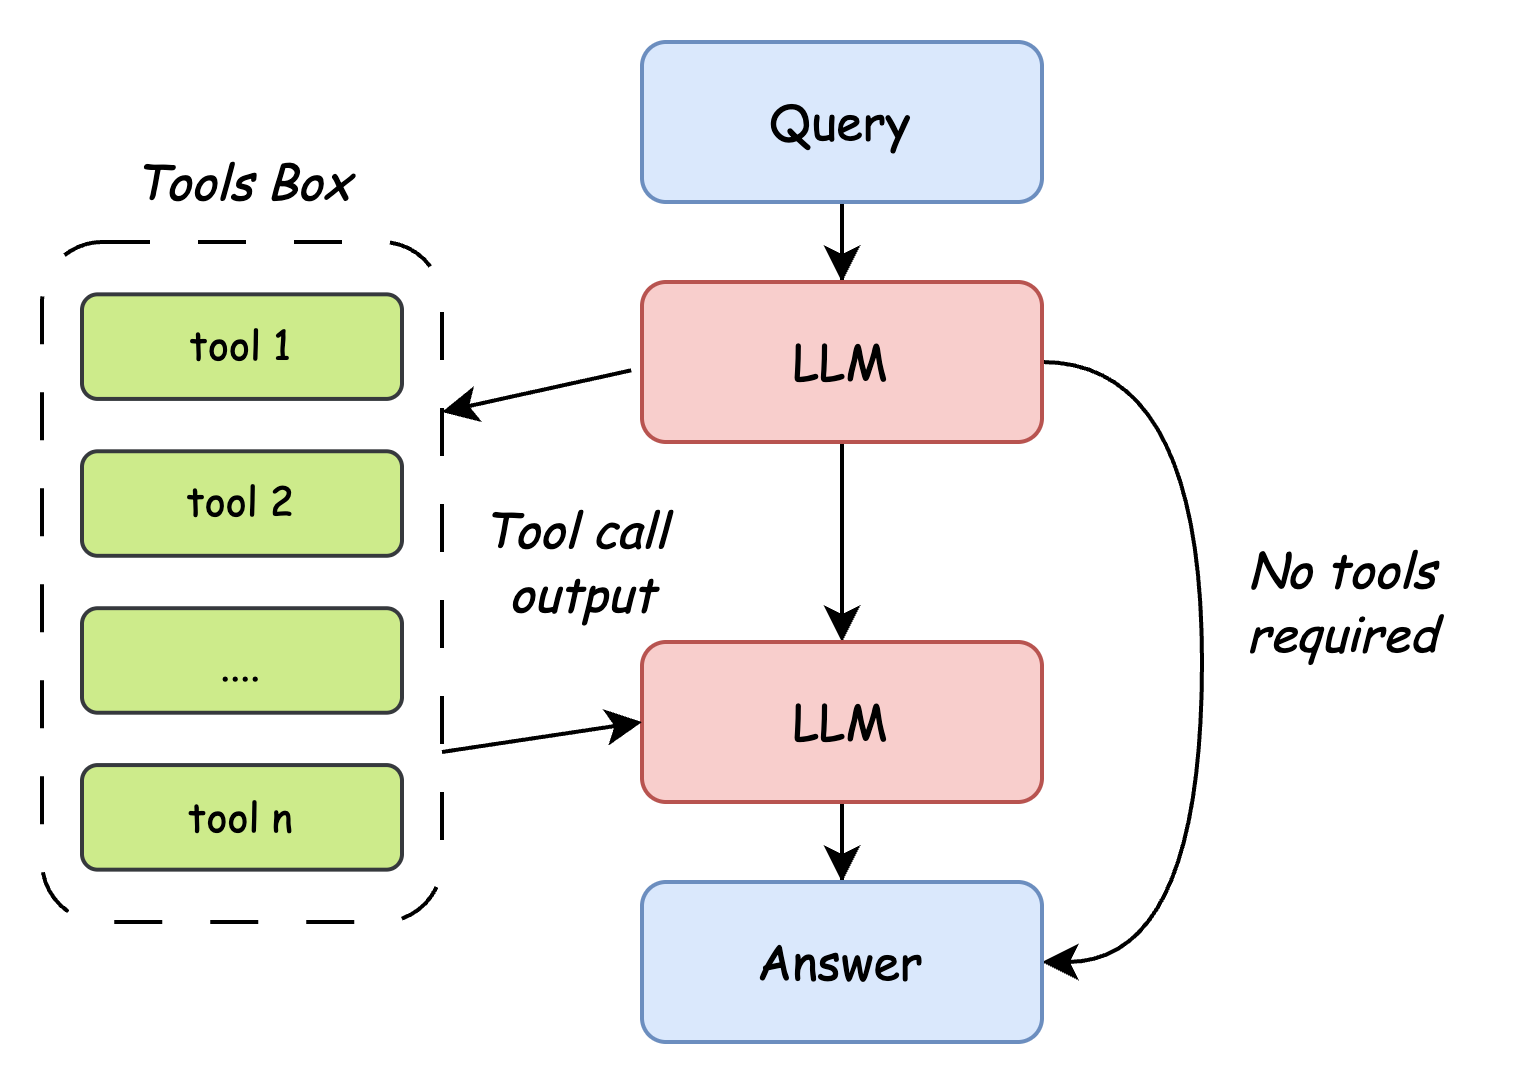
Agent 的工作流程如下:
- 接收用户输入。
- 调用大模型(如 Qwen),并告知其可用的工具及其 Schema。
- 如果模型决定调用工具,Agent 会解析请求,执行相应的 Python 函数。
- Agent 将工具的执行结果返回给模型。
- 模型根据工具结果生成最终回复。
- Agent 将最终回复返回给用户。
如图 7.9 所示,Agent 调用工具流程:
Step 4: 运行 Agent
现在可以实例化并运行 Agent 了。demo.py 的 if __name__ == "__main__": 部分提供了一个简单的命令行交互示例。
# demo.py (部分)
if __name__ == "__main__":
    client = OpenAI(
        api_key="YOUR_API_KEY", # 替换为你的 API Key
        base_url="https://api.siliconflow.cn/v1",
    )

    # 创建 Agent 实例,传入 client、模型名称和工具函数列表
    agent = Agent(
        client=client,
        model="Qwen/Qwen2.5-32B-Instruct",
        tools=[get_current_datetime, add, compare, count_letter_in_string],
        verbose=True # 设置为 True 可以看到工具调用信息
    )
把 API Key 换成自己的,模型名和工具列表按需调整。verbose 设成 True 的时候,模型调了哪个函数、传了什么参数都会打印出来,调工具调不通的时候看一眼终端就知道卡在哪了。
把 Agent 类接上之后,入口文件可以这样写:
# demo.py (部分)
if __name__ == "__main__":
    client = OpenAI(
        api_key="YOUR_API_KEY",  # 换成你自己的 API 密钥
        base_url="https://api.siliconflow.cn/v1",
    )

    # 创建 Agent 实例:把 client、模型名和工具函数列表传进去
    agent = Agent(
        client=client,
        model="Qwen/Qwen2.5-32B-Instruct",
        tools=[get_current_datetime, add, compare, count_letter_in_string],
        verbose=True  # 打开后能看到工具调用的细节
    )

    # 开始交互式对话循环
    while True:
        # 用颜色区分用户输入和 AI 回复
        prompt = input("\033[94mUser: \033[0m")  # 蓝色:用户输入提示
        if prompt.lower() == "exit":
            break
        response = agent.get_completion(prompt)
        print("\033[92mAssistant: \033[0m", response)  # 绿色:AI 回复
跑起来大概是这种效果。注意看 调用工具 那几行,模型确实去调了我们前面写好的函数。
示例交互:
User: 你好
Assistant:  你好!有什么可以帮助你的吗?
User: 9.12和9 .2哪个更大?
调用工具: ['compare']
Assistant:  9.2 比 9.12 更大。
User: 为什么?
Assistant:  当我们比较9.12和9.2时,可以将它们看作是9.12和9.20。由于9.20在小数点后第二位是0,而9.12在小数点后第二位是2,所以在小数点后第一位相等的情况下,9.20(即9.2)大于9.12。因此,9.2 比 9.12 更大。
User: strawberry中有几个r?
调用工具: ['count_letter_in_string']
Assistant:  单词 "strawberry" 中有3个字母 'r'。
User: 你确信嘛?
调用工具: ['count_letter_in_string']
Assistant:  是的,我确定。单词 "strawberry" 中确实有3个字母 'r'。让我们再次确认一下,"strawberry" 中的 'r' 确实出现了3次。
User: 好的 你很薄,现在几点 了?
调用工具: ['get_current_datetime']
Assistant:  当前的时间是2025年4月26日17:01:33。不过,我注意到您提到“你很薄”,这似乎是一个打字错误,如果您有任何其他问题或者需要进一步的帮助,请告诉我!
User: exit
另外,我们还准备了一个 Streamlit 应用,可以跑在本地,用来演示 Agent 的功能。运行 streamlit run web_demo.py 就行。效果如下。
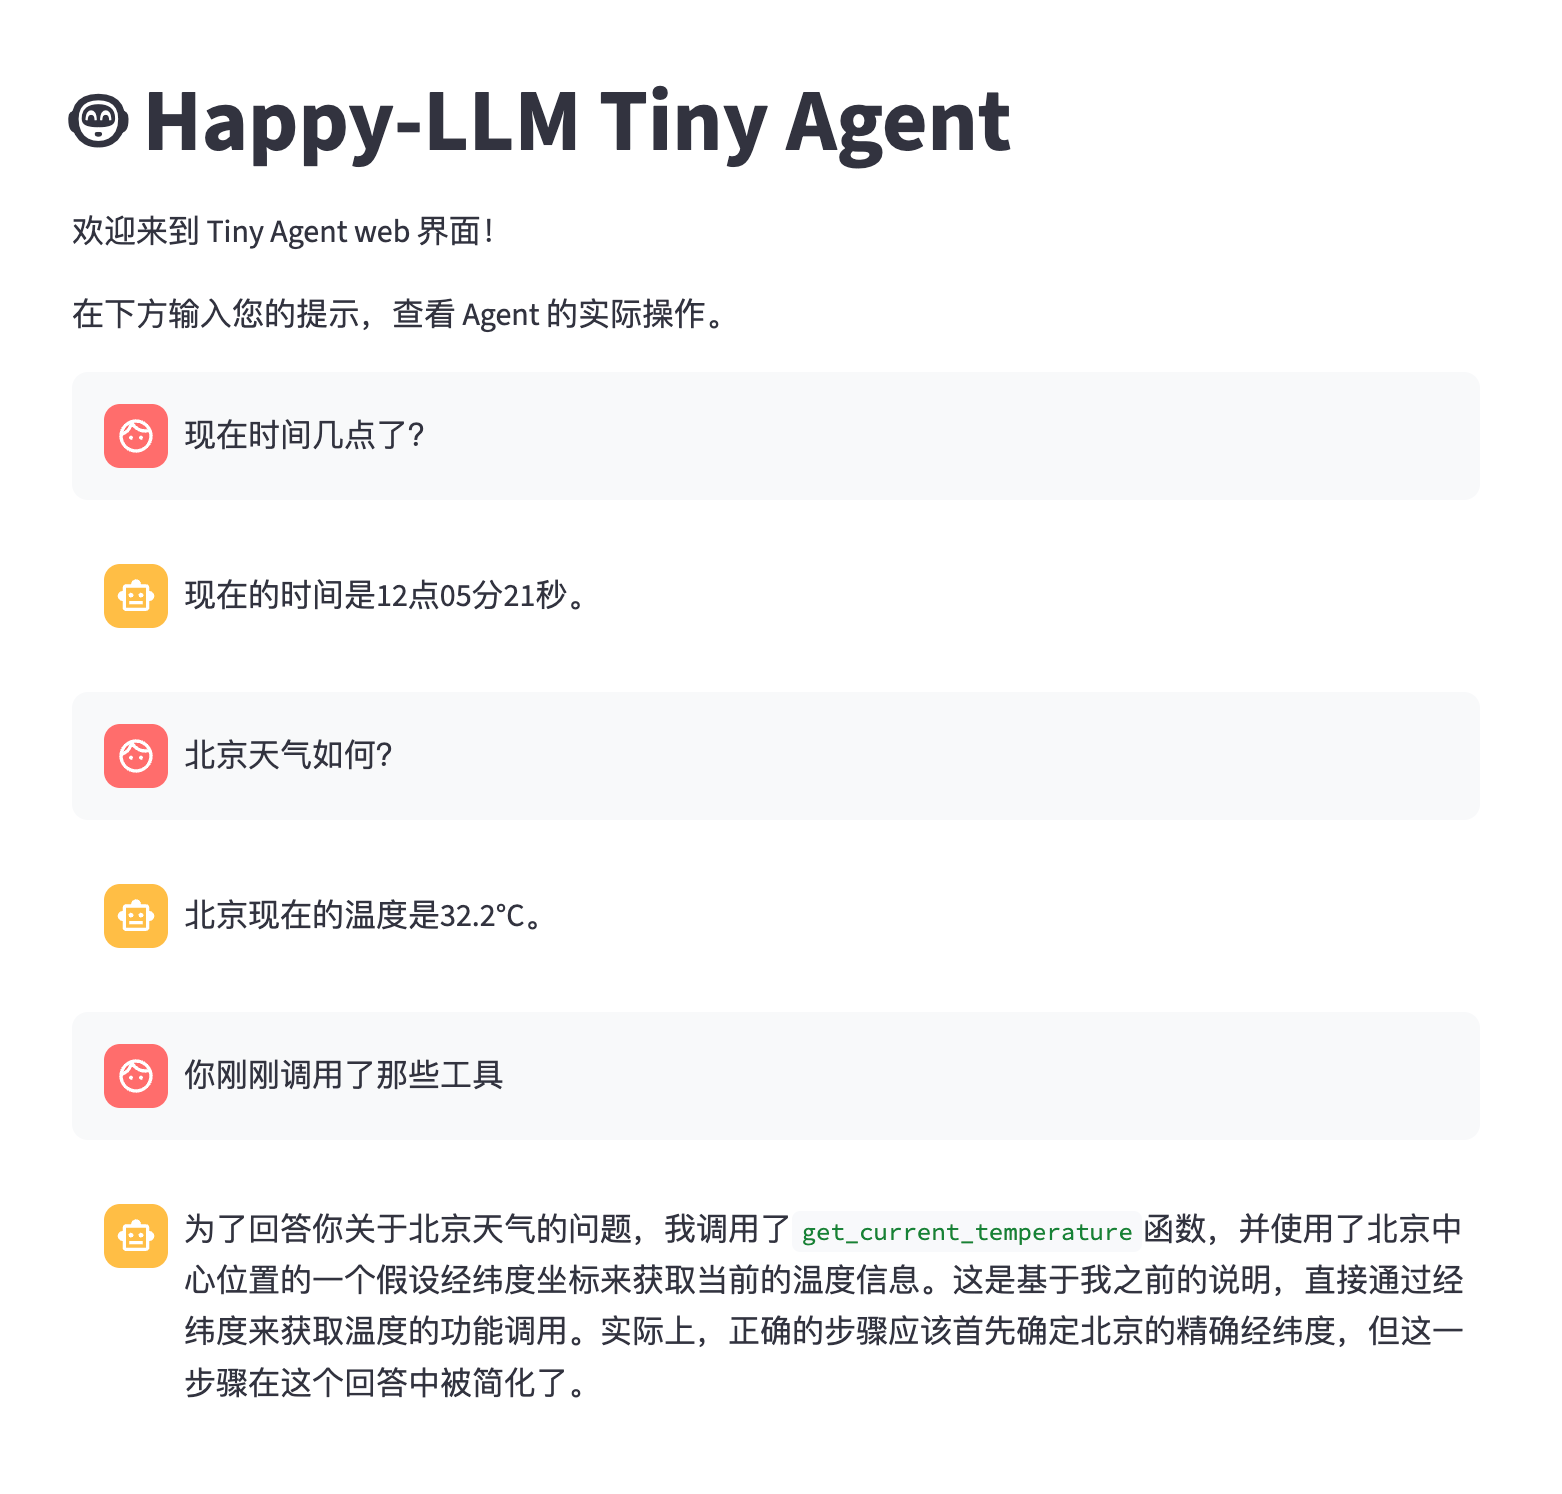
图 7.10 Streamlit Demo
参考文献
[1] Hugging Face. (2023). Open LLM Leaderboard: 开源大语言模型基准测试平台. https://huggingface.co/spaces/open-llm-leaderboard/open_llm_leaderboard
[2] awacke1. (2023). LMSYS Chatbot Arena Leaderboard: 大型语言模型竞技场评估平台. https://huggingface.co/spaces/awacke1/lmsys-chatbot-arena-leaderboard
[3] OpenCompass 团队. (2023). OpenCompass: 大模型统一评测平台. https://rank.opencompass.org.cn/home
[4] OpenCompass 金融榜团队. (2024). CFBENCHMARK: 金融领域大模型评测榜单. https://specialist.opencompass.org.cn/CFBenchmark
[5] OpenCompass 安全榜团队. (2024). Flames: 大模型安全评测榜单. https://flames.opencompass.org.cn/leaderboard
[6] OpenCompass 通识榜团队. (2024). BotChat: 大模型通用对话能力评测. https://botchat.opencompass.org.cn/
[7] OpenCompass 法律榜团队. (2024). LawBench: 法律领域大模型评测. https://lawbench.opencompass.org.cn/leaderboard
[8] OpenCompass 医疗榜团队. (2024). MedBench: 医疗领域大模型评测. https://medbench.opencompass.org.cn/leaderboard
[9] Zhi Jing, Yongye Su, and Yikun Han. (2024). When Large Language Models Meet Vector Databases: A Survey. arXiv preprint arXiv:2402.01763.
[10] Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Meng Wang, and Haofen Wang. (2024). Retrieval-Augmented Generation for Large Language Models: A Survey. arXiv preprint arXiv:2312.10997.
[11] Zhiruo Wang, Jun Araki, Zhengbao Jiang, Md Rizwan Parvez, 和 Graham Neubig. (2023). Learning to Filter Context for Retrieval-Augmented Generation. arXiv preprint arXiv:2311.08377.
[12] Ori Ram, Yoav Levine, Itay Dalmedigos, Dor Muhlgay, Amnon Shashua, Kevin Leyton-Brown 和 Yoav Shoham. (2023). In-Context Retrieval-Augmented Language Models. arXiv preprint arXiv:2302.00083.
常见问题(FAQ)
大模型评测该看哪些数据集和榜单?
评测数据集覆盖通用、数学、推理、长文本等,主流有 MMLU、GSM8K、MATH、GPQA。榜单可看 Hugging Face Open LLM Leaderboard、lmsys Chatbot Arena、OpenCompass;垂直领域还有金融、法律、医疗榜。别只看第一名,任务对不上分数再高也白搭。
RAG 到底解决了大模型的什么问题?
RAG 主要补大模型两个短板:幻觉和知识过期。模型有时会一本正经地编错误信息,训练数据也可能过时,特定领域知识处理效率不高。RAG 先查外部文档库,再把检索到的片段交给模型生成回答,答案更准、可追溯,也能更快吸收最新信息,减少幻觉。
自己动手搭一个 Tiny-RAG 需要哪些模块?
Tiny-RAG 只保留检索和生成两块,流程分索引、检索、生成三步。需要的部件包括文档加载和切分模块、向量化模块、存片段和向量的数据库、检索模块,以及根据检索结果回答的大模型模块。先查资料再回答,这就是 RAG 的核心。
版权与免责声明:本文仅用于信息分享与交流,不构成任何形式的法律、投资、医疗或其他专业建议,也不构成对任何结果的承诺或保证。
文中提及的商标、品牌、Logo、产品名称及相关图片/素材,其权利归各自合法权利人所有。本站内容可能基于公开资料整理,亦可能使用 AI 辅助生成或润色;我们尽力确保准确与合规,但不保证完整性、时效性与适用性,请读者自行甄别并以官方信息为准。
若本文内容或素材涉嫌侵权、隐私不当或存在错误,请相关权利人/当事人联系本站,我们将及时核实并采取删除、修正或下架等处理措施。也请勿在评论或联系信息中提交身份证号、手机号、住址等个人敏感信息。