RAG 到底怎么运转?拆成四步就通了
AI Summary (BLUF)
这篇文章解释了RAG(检索增强生成)的基本原理:它通过引入信息检索组件,先从外部数据源中查找相关信息,再结合用户输入一起交给大语言模型,从而生成更准确的回答。文章还介绍了创建外部数据、检索相关信息、增强提示词以及更新外部数据这四个关键步骤。
核心洞察
RAG 这个概念被讲烂了,但大部分文章一上来就堆术语。这篇难得的地方在于,它把“检索增强生成”拆成了四个能看懂的动作,没有故弄玄虚。如果你一直没搞明白 RAG 到底怎么运转的,看完这四步就通了。
大语言模型回答问题,靠的是训练时记住的东西。它不知道你公司上个月的考勤政策,也没读过你刚上传的那份合同。RAG 要解决的就是这个:让模型在开口之前,先去翻一遍你给它的资料。
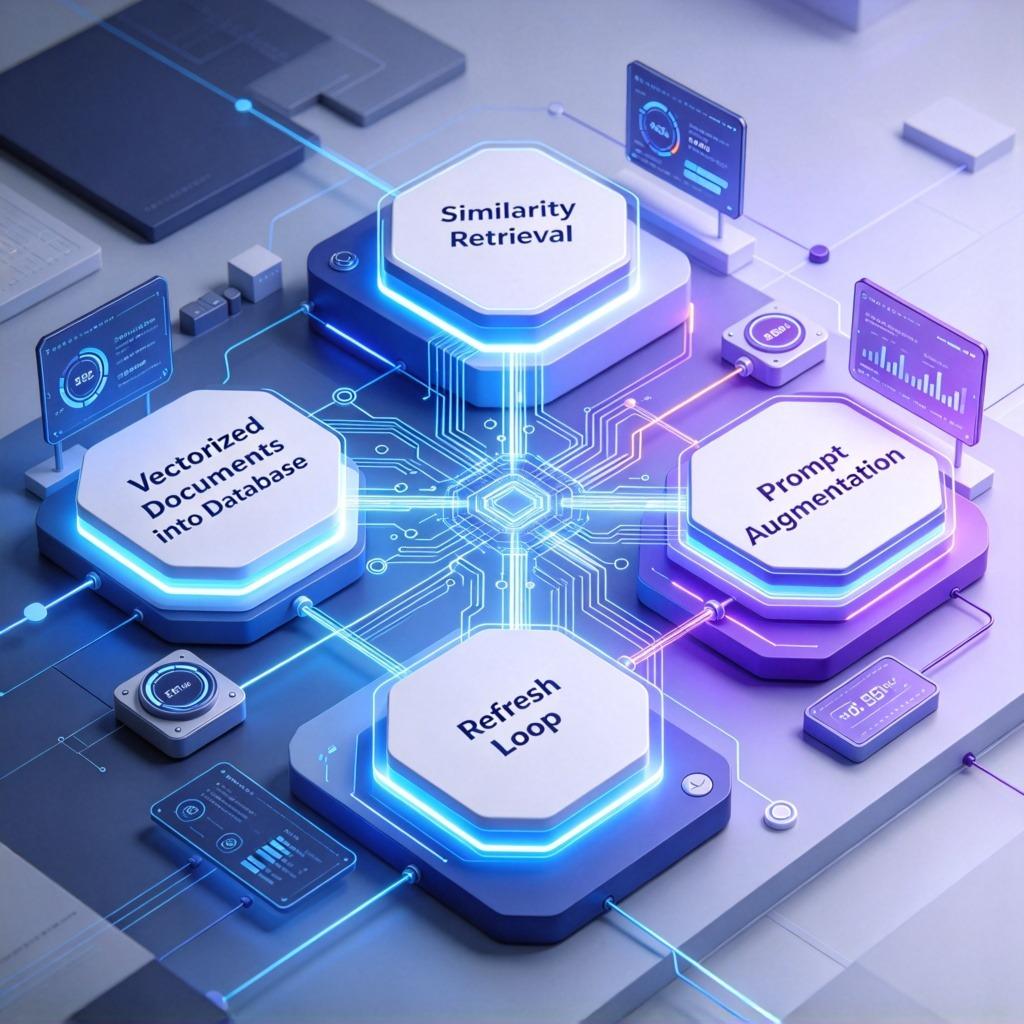
整个流程可以拆成四步来看。
核心结论
RAG(检索增强生成)结合信息检索和文本生成的技术,通过检索相关文档来增强大型语言模型的生成能力。的核心流程可拆解为四个步骤:准备外部数据存在于LLM原始训练数据集之外的新数据,可来自API、数据库或文档库等。、检索相关信息、增强提示词、更新外部数据。
RAG 解决的核心问题是:大语言模型只能依赖训练时记住的知识,无法获知企业内部的实时信息(如最新考勤政策、刚上传的合同),RAG 让模型在生成回答前先检索外部资料。
检索环节通过嵌入模型将用户问题转化为向量,在向量数据库A database system designed to store and perform high-dimensional semantic similarity searches on vector embeddings of data.中做数学匹配(而非关键词匹配),从而找出与问题最相关的资料。例如 HR 问答机器人会同时检索年假政策文档和员工请假记录。
增强环节将检索到的相关资料嵌入用户原始提问中一并提交给大模型,使模型结合补充材料与自身训练知识生成更可靠的答案。
外部数据会过时,需通过实时自动化流程或定时批量处理定期更新文档及其向量表示,以确保检索结果不过时。
第一步:准备外部数据
模型训练时没见过的那些资料,统称为外部数据。来源可以很杂,API、数据库、文档仓库都行。格式也无所谓,文件、数据库记录、大段文字都能用。
这里会用到一个叫嵌入模型的技术,把各种格式的数据转成数字向量,存进向量数据库。你可以把它理解成给模型建了一个它能看懂的图书馆。
第二步:检索相关信息
用户提问之后,系统先把问题也转成向量,然后去向量数据库里做匹配。
举个例子。假设有个公司内部的 HR 问答机器人,员工问“我还有多少年假”。系统会同时捞出年假政策文档和这位员工过去的请假记录。为什么是这两份?因为它们和这个问题在向量空间里离得最近。相关性的计算靠的是数学,不是关键词匹配。
第三步:增强提示词
拿到相关资料后,RAG 会把这些内容塞进用户的原始提问里,一起交给大模型。这一步涉及提示词工程设计和优化输入提示以引导AI模型产生更准确、相关输出的技术。的技巧,目的是让模型能有效利用这些补充信息。
模型拿到的不只是问题,还有回答问题所需的材料。它结合这些新材料和自己的训练知识,生成更靠谱的答案。
第四步:更新外部数据
外部数据会过时。政策改了,文档旧了,向量库里存的还是老版本。
要保持检索结果不过时,就得定期更新文档和对应的向量表示。可以走实时自动化流程,也可以定时批量处理。数据管理本来就是 analytics 里的老问题,换了个场景而已,用的还是那套变更管理的思路。
下面这张图展示了 RAG 和大模型配合的完整流程。
(图片来源:AWS 文档)
常见问题(FAQ)
RAG具体是怎么工作的?能简单解释一下吗?
RAG先检索外部数据,再把相关信息增强到提示词中,最后让大模型生成回答。整个过程包括准备数据、检索信息、增强提示词和更新数据四步,让模型能利用外部知识。
RAG的四个步骤分别是什么?
第一步准备外部数据,用嵌入模型转成向量存库;第二步检索相关信息,将问题向量化后匹配;第三步增强提示词,把资料塞进提问;第四步更新外部数据,定期维护向量库。
为什么RAG需要更新外部数据?
外部数据会过时,比如政策改变或文档更新,向量库中的旧版本会导致检索结果不准确。定期更新文档和向量表示能保证RAG回答的时效性,可以通过实时或批量处理实现。
版权与免责声明:本文仅用于信息分享与交流,不构成任何形式的法律、投资、医疗或其他专业建议,也不构成对任何结果的承诺或保证。
文中提及的商标、品牌、Logo、产品名称及相关图片/素材,其权利归各自合法权利人所有。本站内容可能基于公开资料整理,亦可能使用 AI 辅助生成或润色;我们尽力确保准确与合规,但不保证完整性、时效性与适用性,请读者自行甄别并以官方信息为准。
若本文内容或素材涉嫌侵权、隐私不当或存在错误,请相关权利人/当事人联系本站,我们将及时核实并采取删除、修正或下架等处理措施。也请勿在评论或联系信息中提交身份证号、手机号、住址等个人敏感信息。