上下文工程落地实战:为什么塞满窗口反而让 Agent 变笨
AIAI Summary (BLUF)
上下文工程(Context Engineering)关注的是每次调用 LLM 之前,窗口里该放哪些信息、用什么结构放、什么时候放、什么时候撤。它和 Prompt Engineering 的区别在于:后者关心指令怎么写,前者关心调用前的信息组装。文章系统讲解了上下文失效的原因、评估指标、运行时加载策略、长任务上下文管理,以及工程落地的五个模块和原则。
核心洞察
这篇文章把 Context Engineering 从概念到落地讲得比较完整,但我最想提醒的是:别被"工程"两个字吓到,它的核心思路其实很朴素,就是在每次调用模型之前,想清楚该给它看什么、不该给它看什么。文中那个电商售后的例子特别能说明问题,同一个模型,上下文给对了和给错了,表现差距大得离谱。另外,40% 利用率那个经验值不用当成铁律,不同模型和任务差别很大,自己跑几条真实轨迹比什么都靠谱。
核心结论
Context Engineering 的核心是调用前的信息组装:在每次调用 LLM 之前,明确哪些规则进消息、哪些证据按需检索、哪些工具在当前阶段可见、历史何时压缩、原始结果如何保留引用,而非仅仅关注 Prompt 的措辞和格式。
上下文窗口越大不等于效果越好:40% 左右的利用率是经验最佳区间,超过后边际收益递减;同时存在 Lost in the Middle(中间迷失)和 Context Rot(上下文腐烂)两个核心失效现象,会导致检索不稳、区分变弱和使用退化。
运行时上下文加载有三种策略:预检索适合 FAQ 和固定知识库问答,Just-in-Time 按需加载(Progressive Disclosure)适合代码库分析和故障排查,混合策略(静态知识预加载 + 动态内容按需拉取)最适合复杂业务 Agent 和长任务。
长任务靠三种技术撑住上下文:Compaction 压缩历史保留架构决策和关键结论、Structured Note-taking 让 Agent 写外部笔记跨窗口衔接、Sub-agent 拆分探索只回传约 1000-2000 Token 的高密度摘要。
落地应从可回放基线开始,一次只改一个变量:先选 20-50 条真实任务轨迹做小评测集,固定 System Prompt 与工具边界,验证 RAG 检索,再加摘要压缩和上下文预算;只有基线暴露明确瓶颈后,才引入记忆分层、Compaction 或 Sub-agent,避免过多组件掩盖故障来源。
上下文工程:一文读懂它是什么、和 Prompt Engineering 的区别、以及怎么落地
引子:上下文窗口能装下更多资料,不代表 Agent 会稳定利用这些资料。一次调用里混入过期状态、无关日志或几十个相似工具描述后,模型仍可能漏掉真正影响决策的条件。Context Engineering 处理的就是调用前的信息组装:哪些规则进消息、哪些证据按需检索、哪些工具在当前阶段可见、历史何时压缩、原始结果如何保留引用。
一、同样的 Agent,为什么表现差这么多?
以电商售后为例。用户发来一句:"我上周买的耳机右耳没声音了,怎么处理?"
- 上下文不足时,Agent 只会套流程反问:"请问您购买的是哪款耳机?订单号是多少?能否描述故障表现?"答话没毛病,但对售后场景很恼火;
- 上下文充足时,调用 LLM 之前系统先把能查的都查出来:定位到上周购买记录(索尼 WH-1000XM5、3 月 25 日下单)、确认还在 7 天退换期内、查历史工单发现是老客户无纠纷、挂载
create_return_order和check_inventory工具。Agent 直接给出:"可直接帮您发起换货,仓库显示同款有库存,预计 2-3 天寄出,需要我操作吗?"
结论很确定:上下文不够的时候,模型再强也只能靠猜;上下文给对了,中等水平的模型也能把任务做下去。 当然,Agent 的失败不只是上下文问题,工具设计、任务拆解、状态管理、验证机制通常要一起看。
二、Context Engineering 到底在做什么?
定义(Tobi Lutke):the art of providing all the context for the task to be plausibly solvable by the LLM——给 LLM 补齐解决任务所需的上下文,让任务在模型能力范围内具备可解性。这里的 plausibly 是前提条件:缺少订单状态、权限边界或旧链路约束时,模型没有足够依据作出可靠判断。
和 Prompt Engineering 的差别:
- Prompt Engineering 关心指令怎么写——措辞、顺序、格式、语气;
- Context Engineering 关心另一件事——这轮调用之前,窗口里该放哪些信息、用什么结构放、什么时候放进去、什么时候撤掉。
打个比方:Prompt Engineering 是"告诉厨师这道菜怎么做",Context Engineering 是"给厨师准备厨房"——食材放哪、刀具怎么摆、调料怎么分类、火候参考贴在哪。更精确的类比:Context Engineering 就是 LLM 的内存管理——上下文窗口是有限内存,管的是装什么、换出什么、什么时候读、什么时候写,和操作系统的页面置换(LRU、优先级)是同一思路。
它具体管哪些东西:
| 模块 | 内容 |
|---|---|
| System Prompt | 高优先级指令;注意 .cursor/rules、AGENTS.md 是宿主程序读取的规则来源,与 API 角色意义的 System Prompt 不是同一概念(.cursorrules 已是旧版形式) |
| User Prompt | 用户输入的业务数据和指令,常混着自然语言、业务字段、历史状态、附件内容,处理不好会把上下文搞脏 |
| Memory | 短期=会话滑动窗口;长期不一定是向量库(文件、KV、关系库、图库都行)。关键是记录什么、何时写、怎么更新和遗忘、召回后怎么进入上下文 |
| RAG & Tools | RAG 可以看成 CE 的一种具体实现——回答"检索什么、怎么检索、结果怎么放进上下文" |
| Schema/Function Calling | 参数结构和返回约束限制当前调用;工具调用后的 Observation 要设计保留原文、写摘要还是清理 |
| Token 管理 | 摘要压缩、历史剔除、Context Caching,在信息保留与调用成本间取舍 |
三、上下文为什么会失效?
窗口越大 ≠ 效果越好:边际收益递减,40% 左右利用率是经验最佳区间——信息不足模型只能猜,信息过载干扰多、效果反而下降。
两个核心现象:
- Lost in the Middle(中间迷失):模型对开头和结尾的信息更敏感,夹在中间的内容更容易"看漏"。你把关键结论放中间,它可能根本没当回事;
- Context Rot(上下文腐烂):上下文变长 + 噪声冲突增加 → 检索不稳(关键事实不易定位)、区分变弱(相似信息相互干扰)、使用退化(约束和事实被漏用)→ 准确率和召回率下降。治理建议:目标约束放开头、删除无关日志、最新事实明确标记、结尾总结当前状态。
机制解释:Transformer 不是一行行读文本,而是靠 Attention 做"相关性打分"。上下文短时干扰少容易找重点;一次性塞几十页文档、几百条日志,候选信息越多、干扰越多、注意力越分散。虽然长上下文模型会用稀疏注意力、分块、缓存、压缩来降低成本,但准确的说法是:长上下文会增加模型筛选关键信息的难度和推理成本,退化程度取决于模型本身、上下文结构和任务类型——能放进去和能用好,是两回事。
典型翻车案例:老用户登录改造,历史需求、接口文档、会议记录一起进窗口,关键信息只有一句"老用户登录链路仍依赖旧版 token 校验,不能直接切到新鉴权模块",但它夹在中间被忽略了,模型给出看似合理、实际有风险的方案。
四、怎么评估上下文工程有没有变好?
不能只靠体感——最容易出现的假象是"改完 Agent 更像个样子了,但成功率没提升、成本上去了"。至少盯住五类指标:
| 指标类型 | 具体看什么 |
|---|---|
| 任务成功率 | 是否完成目标、是否需要人工补救、能否稳定复现成功路径 |
| 工具质量 | 错选工具、漏调工具、参数错误、重复调用、危险操作拦截率 |
| 上下文成本 | 输入/输出 Token、缓存命中率、压缩后信息保留比例 |
| 延迟指标 | 首 Token 延迟、端到端耗时、工具等待时间、p95/p99 |
| 结果质量 | 幻觉率、证据引用准确率、摘要丢失率、关键字段遗漏率 |
做法:先选 20-50 条真实任务轨迹做小评测集,改检索、压缩、工具 Schema、Prompt 时每次只改一个变量,否则很难定位效果来源。
五、运行时上下文怎么加载?
| 策略 | 优点 | 代价 | 更适合的任务 |
|---|---|---|---|
| 预检索(Pre-retrieval) | 快、简单、链路稳定 | 容易一次性塞入噪声,执行中不够灵活 | FAQ、固定知识库问答、稳定文档审阅 |
| Just-in-Time 按需加载 | 上下文干净,证据按需进入 | 工具调用多、延迟更高、依赖导航能力 | 代码库分析、故障排查、开放式研究 |
| 混合策略 | 兼顾启动速度和运行时探索 | 需要预算管理器和工具导航能力 | 复杂业务 Agent、长任务、多源检索 |
- 预检索为什么不够:它只能依据调用前已知的目标排序,Agent 调用工具后发现的新线索不会出现在结果里;
- Just-in-Time:先保留文件路径、DB Query、Web 链接等轻量引用,靠元数据(目录结构、文件名、时间戳)导航,需要时再 head/tail/grep 读取。Anthropic 称之为 Progressive Disclosure(渐进式披露)——
tests/test_utils.py与src/core_logic/test_utils.py的路径语义不同,足以提示 Agent 它们服务于不同位置的测试逻辑。缺点:导航能力不足时 Agent 会沿错误路径继续搜索,消耗更多上下文; - 混合策略最现实:确定性高的静态知识(如 CLAUDE.md)预加载,动态内容按需拉取。
选型看任务的材料是否稳定、探索空间多大、实时性要求、证据是否必须可追溯,而不是比较哪种方案"更高级"。
六、长任务里,上下文怎么撑住?
三种武器:
- Compaction(压缩历史):窗口接近上限时把历史压缩为摘要,跨窗口衔接。Anthropic 介绍的思路:保留架构决策、未解决 Bug、关键实现细节、重要结论,丢弃大量工具输出、重复对话和临时中间结果;压缩后再配合"最近访问的文件"恢复任务状态。难点在取舍——保留太多没意义、太少丢关键上下文,实际做法是拿复杂 Agent 轨迹反复调压缩 Prompt。更轻量的手段是清理工具结果(tool-result clearing:保留 tool_use 记录,清理旧 tool_result),触发阈值按业务负载测试;
- Structured Note-taking(记笔记):让 Agent 把关键进展写进外部文件(NOTES.md、to-do list),上下文重置后读取继续。例子:Claude 玩 Pokémon 数千轮游戏里自己维护数值追踪("过去 1234 步在 1 号道路训练皮卡丘,已升 8 级,还差 2 级")和地图、成就清单、战斗策略笔记,跨好几个小时持续推进;
- Sub-agent(拆分探索):检索或代码阅读交给独立上下文的子 Agent,只回传约 1000-2000 Token 的高密度摘要,数万 Token 的详细搜索不占主窗口(Anthropic Multi-Agent Research 系统即此模式)。
| 技术 | 适用场景 |
|---|---|
| Compaction | 需要持续对话的长流程,重点是保持上下文连贯 |
| Note-taking | 迭代式开发、有清晰里程碑、多步推进的任务 |
| Sub-agents | 复杂研究、需要并行探索、最终要汇总结果的任务 |
七、落地:Context Assembler 与五个模块
工程上可以设一个 Context Assembler,每次调用 LLM 前统一组装规则、目标、证据、记忆、工具和历史摘要:
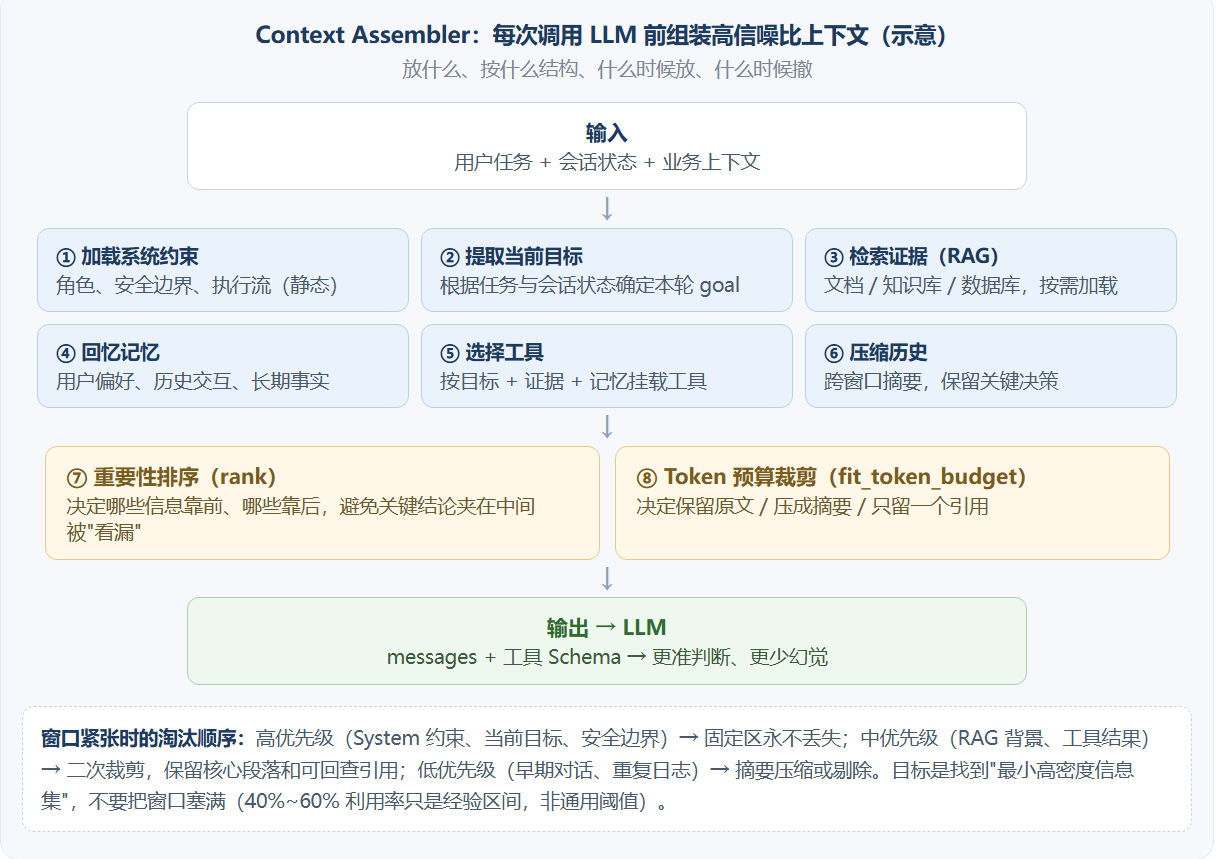
其中 rank 和 fit_token_budget 是最关键的两步——一定要避免"检索回来什么就塞什么、历史能放多少放多少",最后窗口里一半是噪声。
分模块落地要点:
- 静态规则(System Prompt):用结构化 Markdown 拆成角色、目标、约束、执行流、输出格式。避开两个极端——过度设计(大量 if-else 硬塞进 Prompt,又长又脆弱)和过度抽象("做个有帮助的助手"没有决策依据)。理想状态是 Goldilocks zone:具体到能引导行为、抽象到能覆盖常见变化。实操:先用最小 Prompt 测基线,按 failure case 一条条补规则,把 System Prompt 当持续调校的参数而不是写完不动的配置文档;
- 工具上下文:工具描述要能回答"什么时候该调用、什么时候不该调用",明确适用条件和禁止条件,单一操作拆出;一个工具同时覆盖查询/修改/审批时,Agent 错选路径的概率大增;
- 动态上下文:API 报错日志、工具结果先裁剪和摘要,但排障类信息必须保留原始引用(traceId、请求时间、错误码、日志文件位置、调用参数)——只留一句"接口报错了"后面排障会断线。五条失败路径兜底:
| 失败路径 | 兜底方案 |
|---|---|
| RAG 无结果 | 降级到关键词检索,必要时让 Agent 向用户澄清缺口 |
| 工具超时 | 设置超时、重试上限、熔断,关键流程预留人工接管 |
| 摘要丢失 | 保留 traceId、原始证据位置、关键字段和可回查链接 |
| 记忆污染 | 写入前校验,读取后标记来源、时间和可信度 |
| 多工具冲突 | 用优先级、状态机和副作用等级约束调用顺序 |
- 示例上下文(Few-shot):3-5 个能代表策略差异的 canonical examples,通常比把几十个 edge case 全塞进去更有效;示例要说明面对一类输入时应采取的策略,而不只是展示表面输入输出;
- Token 预算(单次调用内):低优先级(早期对话历史)→ AI 摘要压缩;中优先级(RAG 背景、旧工具结果)→ 二次裁剪;高优先级(System Constraints、当前目标、安全边界)→ 固定区永不丢失;阶段性优先级(当前阶段工具描述、Schema、关键示例)→ 按阶段加载,卸载后可重新发现。大规模并发可配合 Prompt/Context Caching 做缓存前缀降本。
八、工具生态与副作用边界
LangChain/LangGraph(控制流、状态管理、循环调度)、LlamaIndex(RAG 数据摄取与检索)、Pinecone/Weaviate/Chroma/Qdrant(向量存储,小项目先本地 Chroma)、MCP(工具标准化接入,2025-11-25 revision 基于 JSON-RPC 2.0,区分 Host/Client/Server)、Mem0/LETTA/ZEP(记忆层)。通过 MCP 接入的工具也是副作用入口——读文件、查数据库、发请求、改配置要区分权限、调用条件与审计边界,否则问题难以定位和回放。
九、落地原则:先记录、再基线、从简单开始
- 先记录每轮实际进入窗口的消息——检索策略、摘要方式、工具 Schema 挂载顺序变化后,才能和基线比较成功率、Token 成本和工具质量;
- 高信噪比 > 信息量:40%-60% 利用率只是经验区间(Dex Horthy),不是通用阈值;从真实轨迹找出完成决策所需的最小信息集,保留约束和证据,移除无关背景;
- 长任务要主动清理过期状态:Compaction、结构化笔记、Sub-agent 组合使用;短任务尚未出现上下文膨胀时,无需引入复杂记忆层;
- 先让最简单的方案跑通(do the simplest thing that works):基线没跑通就加记忆分层、复杂检索和长期状态管理,失败后分不清问题来自检索、摘要、工具描述还是模型选型。顺序是:固定 System Prompt 与工具边界 → 验证 RAG 检索 → 加摘要压缩和上下文预算 → 长任务出现明确瓶颈后再评估记忆层和 Sub-agent;
- 从可回放的基线开始:固定高优先级指令和工具定义,保存每次调用实际发送的消息、Schema、Token 用量和检索结果,一次只调一个变量;设计文档记录 model ID、接口版本和核对日期,别把某个客户端的实现细节当通用规律。
总结
每次调用交给模型的固定规则、当前目标、检索证据、可用工具、历史状态和 Token 预算,都需要按优先级组织。窗口变大不会自动改善判断——无关历史、重复工具结果和过时状态仍会干扰决策。先保存真实调用轨迹、建立可回放基线,再逐项调整检索、工具描述、摘要或裁剪策略;只有基线暴露出长任务、信息过期或窗口不足等问题时,才增加记忆分层、Compaction、缓存或 Sub-agent,以免过多组件掩盖故障来源。
常见问题(FAQ)
上下文工程和 Prompt Engineering 到底有什么区别?
Prompt Engineering 关心指令怎么写,比如措辞、顺序、格式、语气;上下文工程关心这轮调用前窗口里放哪些信息、用什么结构放、什么时候放、什么时候撤。前者是告诉厨师怎么做菜,后者是给厨师准备厨房。
为什么上下文窗口越大,Agent 效果反而可能变差?
边际收益递减,40% 左右利用率是经验最佳区间。信息不足模型只能猜,信息过载则干扰增多。加上 Lost in the Middle 和 Context Rot,关键内容夹在中间容易被忽略,准确率和召回率都会下降。
长任务里上下文快满了,工程上一般怎么处理?
常用 Compaction 压缩历史,保留架构决策、未解决 Bug、关键实现细节和重要结论,丢弃大量工具输出与重复对话,再配合最近访问文件恢复状态。更轻量的做法是清理工具结果,控制信息保留与成本。
版权与免责声明:本文仅用于信息分享与交流,不构成任何形式的法律、投资、医疗或其他专业建议,也不构成对任何结果的承诺或保证。
文中提及的商标、品牌、Logo、产品名称及相关图片/素材,其权利归各自合法权利人所有。本站内容可能基于公开资料整理,亦可能使用 AI 辅助生成或润色;我们尽力确保准确与合规,但不保证完整性、时效性与适用性,请读者自行甄别并以官方信息为准。
若本文内容或素材涉嫌侵权、隐私不当或存在错误,请相关权利人/当事人联系本站,我们将及时核实并采取删除、修正或下架等处理措施。也请勿在评论或联系信息中提交身份证号、手机号、住址等个人敏感信息。