MI300X 上跑 Gemma 4 E2B:fp8 最快,却离原始权重最远
本文提供了在单张AMD Instinct MI300X上通过vLLM部署Gemma 4 E2B十种权重格式的逐步指南,并在相同请求数和提示长度下进行了性能测试。结果显示,fp8格式速度最接近bf16,而int8和4位格式较慢。所有日志、报告和脚本均已开源。
从Word2Vec到GPT-3:Embedding如何成为大模型的翻译官
Embedding是将文本、图像等数据转换为语义向量的核心技术,经历了从Word2Vec到BERT、GPT的动态嵌入演进,并扩展至多模态。本文系统介绍了Embedding的概念、发展历程、常见模型及实际应用示例,帮助读者深入理解大模型处理流程中的关键环节。
RAG、知识图谱与多智能体:AI搜索引擎如何决定引用谁
2026年AI搜索引擎正在重构信息获取方式,GEO(生成式引擎优化)从概念走向商业化落地。本文从RAG检索增强、知识图谱、多智能体协同三项核心技术出发,梳理全栈自研、垂直专精、SaaS工具三类服务模式,并给出技术选型FAQ与趋势展望,帮助技术从业者理解AI搜索优化的底层逻辑与选型要素。
GEO不是讨好AI:让内容被引用的三大策略与实战数据
GEO(生成式引擎优化)是AI搜索时代的新兴优化范式,目标是让品牌内容被ChatGPT Search、Perplexity等AI引擎引用并出现在生成答案中。本文系统解析了GEO的核心概念、RAG架构工作原理、三大优化策略(E-E-A-T强化、结构化数据部署、语义完整性优化),并通过实战案例展示了优化前后的显著效果差异。
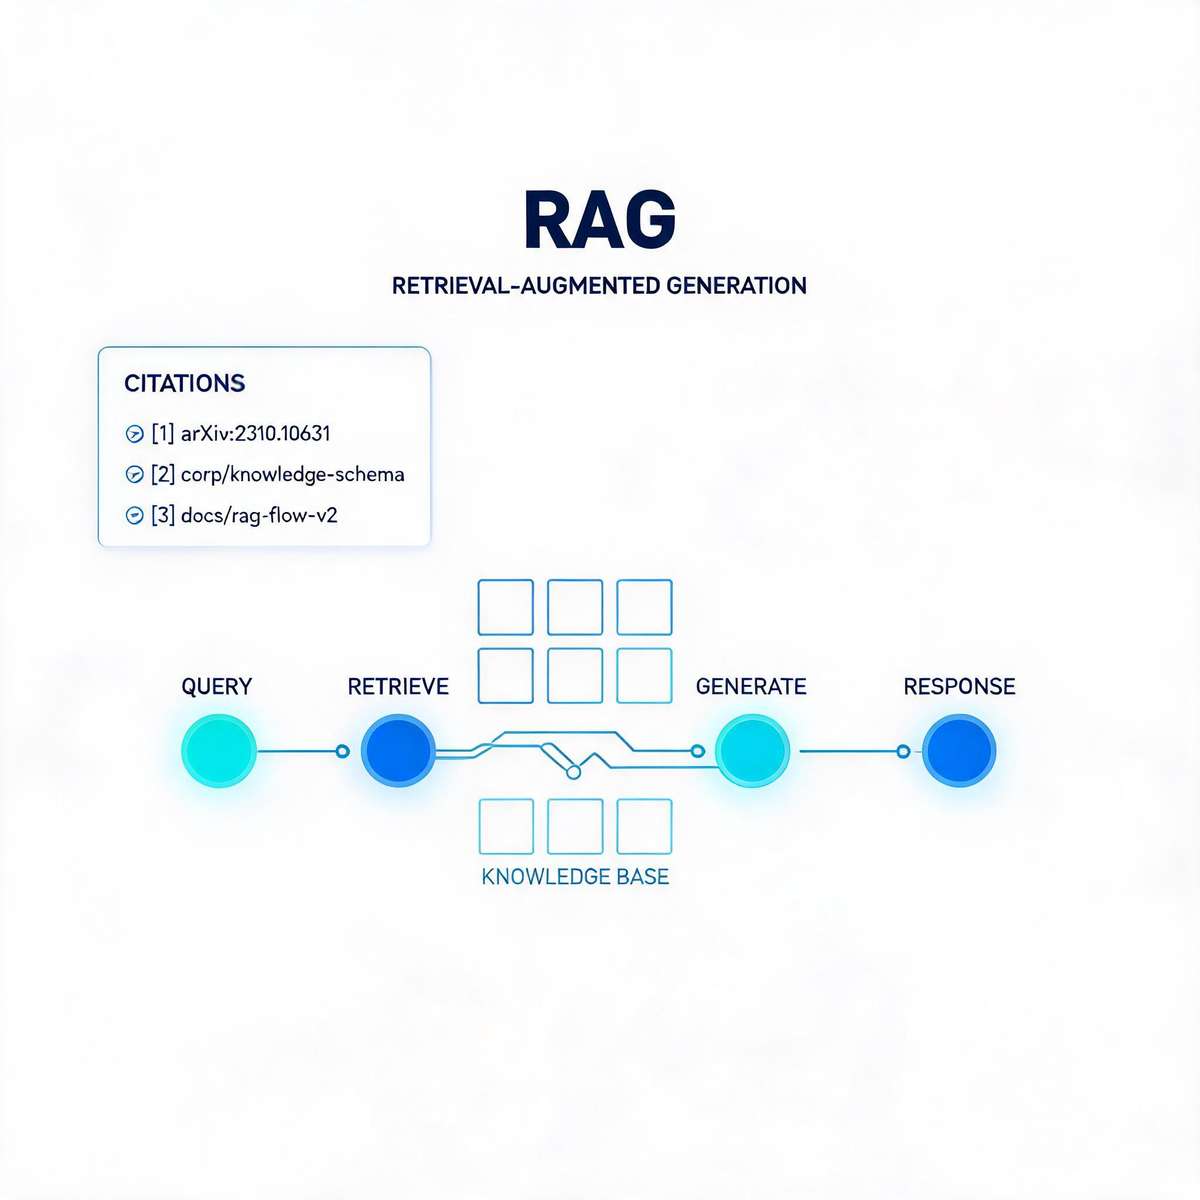
开源向量模型反超商业API:MTEB榜单背后的RAG选型逻辑
这篇文章系统讲解了Embedding模型的工作原理,盘点了2026年MTEB排行榜上的主流文本向量化模型,并针对RAG应用给出了详细的选型建议。无论你是做中文知识库还是多语言检索,都能从中找到适合自己场景的模型方案。
把生成式 AI 塞进数据库:AlloyDB 语义搜索与自然语言生成 SQL 实测
本文介绍了如何利用Google Cloud数据库(如AlloyDB和Cloud SQL)的AI集成功能,通过动手实验展示语义搜索、多模态嵌入、AI函数和自然语言生成SQL等应用,帮助开发者将数据与生成式AI模型结合,构建生产级AI应用。
结构化数据:GEO 投入产出比最高的一步,7 种 Schema 代码示例
结构化数据是AI搜索引擎理解网页内容的翻译层,没有它AI只能靠猜。本文推荐使用JSON-LD格式,并详细给出7种最常用的Schema类型(Article、FAQPage、HowTo、Organization、BreadcrumbList、Product、LocalBusiness)的代码示例和注意事项,最后强调用工具验证标记正确性。
GEO优化不是堆内容:JSON-LD、链接图谱与实体一致性三步闭环
GEO优化的核心不是堆砌内容,而是让AI能读懂、信任并引用你的信息。本文拆解三阶实战技术:部署JSON-LD结构化数据让AI精准解析页面,搭建链接图谱建立实体权威关联,校验全网实体一致性杜绝信息冲突。三步形成完整闭环,新手也能照着操作。
结构化数据是必要非充分条件:四类 Schema 的 GEO 部署实测
结构化数据是GEO的技术内核,通过Schema.org标准为网页添加机器可读的语义标记,能显著降低AI模型解析内容的成本、提升被引用概率。本文从技术角度拆解JSON-LD格式的部署方法,覆盖Article、FAQPage、Organization、HowTo四类常用Schema的代码实现,并给出AI爬虫可访问性的系统排查流程与避坑清单。
280篇文章