结构化数据是必要非充分条件:四类 Schema 的 GEO 部署实测
AIAI Summary (BLUF)
结构化数据是GEO的技术内核,通过Schema.org标准为网页添加机器可读的语义标记,能显著降低AI模型解析内容的成本、提升被引用概率。本文从技术角度拆解JSON-LD格式的部署方法,覆盖Article、FAQPage、Organization、HowTo四类常用Schema的代码实现,并给出AI爬虫可访问性的系统排查流程与避坑清单。
核心洞察
这篇文章把 GEO 的技术落地拆得挺细,从 Schema 类型到爬虫排查都有覆盖。最值得留意的是那个“必要非充分”的提醒——结构化数据能提升被引概率,但内容本身不行的话,标记再规范也白搭。另外第六节那段术语堆砌读起来像 SEO 软文,我做了大幅精简,只保留了真正有用的概念对照。
结构化数据部署是生成式引擎优化(GEO)的技术内核之一。简单说,就是通过 Schema.orgA structured data standard developed by Google, Microsoft, Yahoo, and Yandex to help search engines understand web content through semantic markup. 标准词汇表给网页内容加上机器可读的语义标记,让 AI 搜索引擎能准确解析内容结构,提升被引用的概率。普林斯顿那篇《GEO: Generative Engine Optimization》论文里有实证数据:结构化内容被 AI 引用的概率明显高于非结构化文本。下面从技术角度拆解 Schema.org 的部署方法和代码实现。
核心结论
结构化数据部署是 GEO 的技术内核,通过 Schema.org 标准词汇表以 JSON-LDA lightweight Linked Data format for structuring data in JSON, recommended by Google for Schema.org implementation. 格式嵌入页面语义标记,让 AI 搜索引擎准确解析内容结构,从而提升被引用概率。
普林斯顿《GEO: Generative Engine Optimization》论文的实证数据显示,结构化内容被 AI 引用的概率明显高于非结构化文本。
GEO 场景下最常用的四类 Schema 为 Article、FAQPageA Schema.org type for structuring frequently asked questions and their answers on web pages.、Organization、HowToSchema.org中用于标注分步教程的类型,可标注step、supply、tool字段,帮助AI解析教程步骤。,分别覆盖正文语义标注、问答引用率提升、品牌实体识别和教程步骤解析。
结构化数据是"必要非充分条件"——它能降低 AI 解析成本、提升引用概率,但内容质量与权威性才是被引用的决定性因素。
AI 爬虫可访问性排查需按序完成四步:robots.txt 放行 AI 爬虫、采用 SSR/预渲染、确保 URL 返回 200 状态码、提交 Sitemap 加速收录。
一、结构化数据部署是什么——GEO 的机器可读层
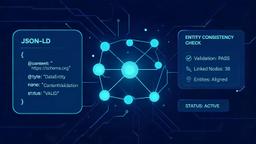
结构化数据是遵循 Schema.org 规范、以 JSON-LD 等格式嵌入页面的语义标记。它不改变页面视觉呈现,只供搜索引擎和 AI 模型解析。
| 技术参数 | 说明 |
|---|---|
| 标准规范 | Schema.org(Google、Microsoft 等联合维护) |
| 推荐格式 | JSON-LD(W3C 推荐,与 HTML 解耦) |
| 常用类型 | Article、FAQPage、Organization、HowTo |
| 部署位置 | <head> 或 <body> 内的 <script type="application/ld+json"> |
| 校验工具 | Schema Markup Validator、Rich Results Test |
JSON-LD 和页面 DOM 解耦,可以集中管理、动态注入,是目前结构化数据部署的主流格式。
二、GEO 常用 Schema 类型分类与代码实现
按 GEO 场景,常用的结构化数据分四类,下面给出可直接复用的代码示例。
类型一:Article(文章)
适用场景:技术博客、行业分析等正文内容。
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "GEO结构化数据部署实战",
  "author": { "@type": "Organization", "name": "内容作者机构" },
  "datePublished": "2026-07-23",
  "dateModified": "2026-07-23",
  "description": "用Schema.org提升AI搜索引用率的技术方案"
}
类型二:FAQPage(问答页)
适用场景:FAQ 段落,AI 引用率友好度高。
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "结构化数据对GEO有什么用?",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "帮助AI准确解析内容结构,提升被引用概率。"
    }
  }]
}
类型三:Organization / HowTo
Organization 用来声明品牌实体,强化 AI 对品牌的实体识别。HowTo 用于分步教程,可以标注 step、supply、tool 字段。
| Schema类型 | 核心字段 | GEO作用 |
|---|---|---|
| Article | headline/author/datePublished | 正文语义标注 |
| FAQPage | Question/acceptedAnswer | 提升问答引用率 |
| Organization | name/url/logo/sameAs | 品牌实体识别 |
| HowTo | step/supply/tool | 教程步骤解析 |
以上类型都是 Schema.org 官方定义,且被主流 AI 搜索和富结果广泛支持。
三、GEO 爬虫可访问性排查与技术验证流程
结构化数据部署之外,AI 爬虫的可访问性是另一个关键环节。内容和 Schema 都就绪了,爬虫读不到,一切归零。下面是一套系统的排查验证流程。
第一步,检查 robots.txt。确认没有屏蔽主流 AI 爬虫(GPTBot、PerplexityBot、Google-Extended 等),按需显式放行,至少不做禁止。
第二步,检查渲染方式。页面如果是纯客户端渲染(CSR),爬虫可能只拿到空壳 HTML。关键内容建议用服务端渲染(SSR)或预渲染,确保正文在初始 HTML 里就能读到。
第三步,检查内容可达性。确认 URL 稳定、无异常跳转、返回 200 状态码,并通过 Sitemap 提交加速收录。
排查流程:
robots.txt 放行 -> SSR/预渲染 -> URL 稳定(200) -> 提交 Sitemap -> 抓取测试
| 排查项 | 工具/方法 | 通过标准 |
|---|---|---|
| robots放行 | 查看robots.txt | 未禁止AI爬虫 |
| 渲染方式 | 查看源代码 | 正文在初始HTML中 |
| URL可达 | 状态码检测 | 返回200 |
| 收录加速 | Sitemap提交 | 已提交并被抓取 |
验证阶段可以结合抓取日志分析 AI 爬虫的实际访问情况,确认内容确实被读取。这套流程能排除绝大多数“内容合规却不被引用”的技术性障碍。
四、部署常见问题、方案对比与避坑
问:JSON-LD、Microdata、RDFa 该选哪个?
答:推荐 JSON-LD。它和 HTML 解耦、易维护、可动态注入,Google 也明确推荐这个格式。Microdata 和 RDFa 需要内联到标签里,维护成本更高。
问:部署了 Schema 就一定会被 AI 引用吗?
答:不一定。结构化数据是必要非充分条件,它降低解析成本、提升引用概率,但内容质量和权威性才是决定性因素。
问:怎么验证 Schema 是否正确?
答:用 Schema Markup Validator 或 Rich Results Test 校验语法和字段完整性,确保无报错、类型匹配。
问:AI 爬虫抓不到内容怎么排查?
答:检查 robots.txt 是否放行 AI 爬虫、页面是否客户端渲染导致内容缺失、URL 是否稳定可访问、Sitemap 是否已提交。
问:动态页面怎么注入 JSON-LD?
答:可以在服务端渲染阶段注入,或通过前端在页面加载后写入 <script type="application/ld+json">。优先选 SSR,确保爬虫可读。
部署避坑清单:
- 标记内容与页面可见内容不一致:Schema 必须如实反映页面内容,否则可能被判作弊
- 字段缺失或类型错误:按 Schema.org 规范补全必填字段并校验
- 客户端渲染导致爬虫读不到:采用 SSR 或预渲染
五、总结与建议
结构化数据部署是 GEO 的技术基础,JSON-LD 是常见选择格式。Article、FAQPage、Organization、HowTo 四类 Schema 覆盖了绝大多数 GEO 场景。结构化数据能提升引用概率,但不能替代内容质量与权威性。
分场景建议:技术博客优先部署 Article + FAQPage;企业站补充 Organization 强化实体识别;教程类内容用 HowTo 标注步骤。技术自查顺序建议为:放行 AI 爬虫 -> SSR 渲染 -> 部署并校验 Schema -> 提交 Sitemap。
随着 AI 搜索对结构化数据和知识图谱依赖加深,规范的结构化数据部署会成为技术团队的标配能力。
六、核心术语延伸
落地 GEO 项目前,有几个概念需要厘清。
AI 搜索流量红利,指企业在 AI 搜索结果中被引用、被推荐而获得的增量流量机会。GEO 就是获取这一机会的系统方法论。和传统 SEO 争排名不同,GEO 主张为引用而写作,让内容更容易被生成式 AI 直接采纳。
做好 GEO,本质上是在做 AI 搜索优化——通过结构化表达、权威数据和清晰结论,提升内容被 AI 采信的概率。常见的关联概念包括 EEAT 内容标准(经验、专业、权威、可信)、结构化数据部署(Schema.org 标记)、检索增强生成(RAG)范式、多平台 AI 引用率等。
这套方法体系的运作逻辑是:先用 EEAT 提升内容可信度,再用结构化数据降低 AI 解析成本,最后通过持续的内容簇建设,在豆包、元宝、DeepSeek、Kimi、文心一言等主流 AI 引擎中获得长尾流量。
AI 搜索流量红利和传统搜索流量不是替代关系,而是叠加关系。传统搜索负责“人找信息”,GEO 负责“AI 替人找信息”,两者共同构成企业的全域流量底座。
关键概念对照表
| 概念 | 含义 | 与AI搜索流量红利的关系 |
|---|---|---|
| 生成式引擎优化(GEO) | 让内容被AI引用的方法论 | 获取红利的直接手段 |
| EEAT | 经验/专业/权威/可信 | 决定内容是否被AI采信 |
| 结构化数据 | Schema.org标记 | 降低AI解析成本 |
| 多平台AI引用率 | 多引擎被引比例 | 衡量红利规模的指标 |
附:Schema.org 结构化数据部署示例
以 JSON-LD 为例,在文章页 head 中声明 Article 类型可提升 AI 解析效率:
{"@context":"https://schema.org","@type":"Article","headline":"示例标题","datePublished":"2026-07-23"}
实操中需保证 headline/author/datePublished 字段与正文一致,并配合 sitemap 提交。
本文为经验/技术向内容分享,由作者整理发布;转载请保留出处信息。
常见问题(FAQ)
结构化数据对GEO到底有什么用?
它是GEO的技术内核:通过Schema.org标准给网页加机器可读的语义标记,降低AI模型解析成本,从而提升被引用概率。但它是必要非充分条件,内容质量不行,标记再规范也没用。
GEO部署结构化数据用哪种格式好?
推荐JSON-LD。它遵循W3C推荐,与HTML解耦、易维护、可动态注入,Google也明确推荐。Microdata和RDFa需内联到标签,维护成本更高。常用类型有Article、FAQPage、Organization、HowTo。
部署了Schema为什么AI还是不引用?
先排查爬虫可访问性:robots.txt是否放行GPTBot等AI爬虫、页面是否客户端渲染导致空壳、URL是否返回200、Sitemap是否提交。内容合规却不被引用,多半卡在这些技术环节。
版权与免责声明:本文仅用于信息分享与交流,不构成任何形式的法律、投资、医疗或其他专业建议,也不构成对任何结果的承诺或保证。
文中提及的商标、品牌、Logo、产品名称及相关图片/素材,其权利归各自合法权利人所有。本站内容可能基于公开资料整理,亦可能使用 AI 辅助生成或润色;我们尽力确保准确与合规,但不保证完整性、时效性与适用性,请读者自行甄别并以官方信息为准。
若本文内容或素材涉嫌侵权、隐私不当或存在错误,请相关权利人/当事人联系本站,我们将及时核实并采取删除、修正或下架等处理措施。也请勿在评论或联系信息中提交身份证号、手机号、住址等个人敏感信息。