DeepSeek 的工程哲学:MLA 压缩与 MoE 拆解如何实现高效推理BLUFDeepSeek是深度求索公司推出的国产大模型系列,凭借多头潜在自注意力(MLA)机制、混合专家(MoE)架构创新,大幅提升长文本处理与推理效率。本文详解其技术原理、三阶段训练策略及金融、移动端等实际应用,展现其兼顾性能与成本的设计理念。DeepSeek2026/9/1阅读全文 →
置顶GAS 不够用?把重活扔给 Gemini 沙箱,用 ggsrun 直传绕开 50MB 和配额限制BLUF这篇文章介绍了一种将 Google Apps Script 与 Gemini 托管代理提供的 Linux 沙盒集成的架构,以执行 GAS 本身无法完成的高负载任务。通过 ggsrun 工具实现云到云的直接文件传输,规避了 API 响应大小和 token 配额限制,大幅提升吞吐和效率。文章提供了完整的客户端库和使用步骤,适合需要突破 GAS 限制的开发者。实验与实测2026/8/31阅读全文 →
Happy-LLM是Datawhale推出的系统性大语言模型BLUFHappy-LLM是Datawhale推出的系统性大语言模型学习教程,从NLP基础出发,深入讲解Transformer架构、预训练语言模型、大语言模型原理,并手把手教你用PyTorch实现和训练LLaMA2等模型。教程覆盖预训练、微调、RAG、Agent等前沿技术,并提供配套模型、PDF和PPT资源,适合有一定Python和深度学习基础的开发者深度学习。AI大模型2026/8/31阅读全文 →
文章还提供了可直接使用的GEO文章生成提示词,帮助营销人快速上手实战BLUF本文系统拆解了GEO(生成式引擎优化)的核心方法论,从AI大模型的工作原理(RAG、Embedding等)出发,详细讲解了如何通过结构化内容、权威性建设、渠道选择等手段让内容被AI识别和引用。文章还提供了可直接使用的GEO文章生成提示词,帮助营销人快速上手实战。AI大模型2026/8/31阅读全文 →
本文系统介绍知识图谱的核心概念、两层结构(数据层与模式层)、BLUF本文系统介绍知识图谱的核心概念、两层结构(数据层与模式层)、完整构建流程(数据获取、信息抽取、知识融合、知识加工)以及典型应用场景。重点讲解信息抽取中的实体、关系和属性抽取技术,知识融合中的实体消歧与指代消解,以及知识加工中的本体构建、质量评估和知识推理,帮助读者理解从原始数据到可推理知识网络的完整过程。AI大模型2026/8/30阅读全文 →
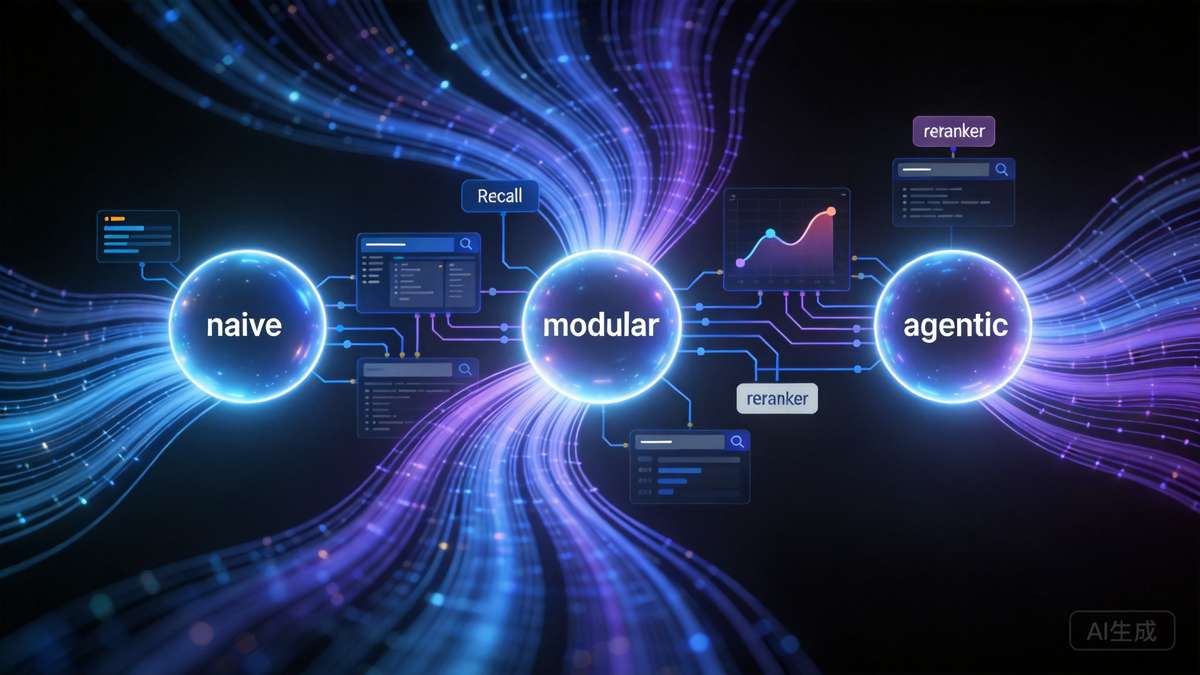
置顶RAG 两年三代演进:为什么多数场景 Advanced RAG 才是性价比之选BLUF本文系统梳理了RAG技术三代演进:Naive RAG基础架构、Advanced RAG的检索优化(查询重写、HyDE、Reranker、混合检索、上下文压缩),以及Agentic RAG的智能体化(规划、工具调用、自我纠错)。通过对比和代码示例,帮助读者理解各代特点及2026年最新进展。GEO技术2026/8/30阅读全文 →
重点提醒用户注意域名安全、数据隐私和对生成内容进行人工复核BLUF本文主要介绍如何核验ChatGPT官网入口,区分官方网页版与第三方中文版,并说明国内使用的合规边界与注册登录步骤。同时提供了文件上传、Deep Research、图片生成等实用功能的使用方法,以及日常办公中的Prompt技巧。重点提醒用户注意域名安全、数据隐私和对生成内容进行人工复核。AI大模型2026/8/30阅读全文 →
这是一份面向初学者的RAG(检索增强生成)学习指南BLUF这是一份面向初学者的RAG(检索增强生成)学习指南。文章先解释了RAG的定义和四大核心优势(准确性、实时性、成本效益、隐私保护),然后规划了一条从基础到高级的9项目学习路径,并介绍了使用的主要技术栈,帮助读者系统掌握RAG技术。AI大模型2026/8/29阅读全文 →
AI、机器学习、深度学习、生成式AI:一套套娃,层层包含BLUF人工智能(AI)技术正在重塑各行各业。本文从基础概念出发,系统梳理了AI、机器学习、深度学习和生成式AI之间的层级关系,并介绍了基础模型、Transformer等核心技术,帮助读者快速建立对AI的整体认知。AI大模型2026/8/29阅读全文 →